
O servidor está saudável?
A rotina de verificação de saúde e o que fazer, como paliativo, quando a resolução está degradada por causa da rede.
Duas coisas nesta página. A primeira é a rotina — o que olhar todo dia e o que olhar de tempos em tempos, para descobrir problema antes do assinante. A segunda é o que fazer quando a resolução já está degradada e você precisa manter a base navegando enquanto a causa é corrigida.
Paliativo é paliativo
As três medidas da segunda metade desta página resolvem o sintoma. Nenhuma delas conserta a causa, e duas delas têm consequência real — uma de latência, outra de privacidade. Anote o que ligou e a data. Paliativo esquecido ligado vira configuração permanente por acidente.
Onde clicar, passo a passo
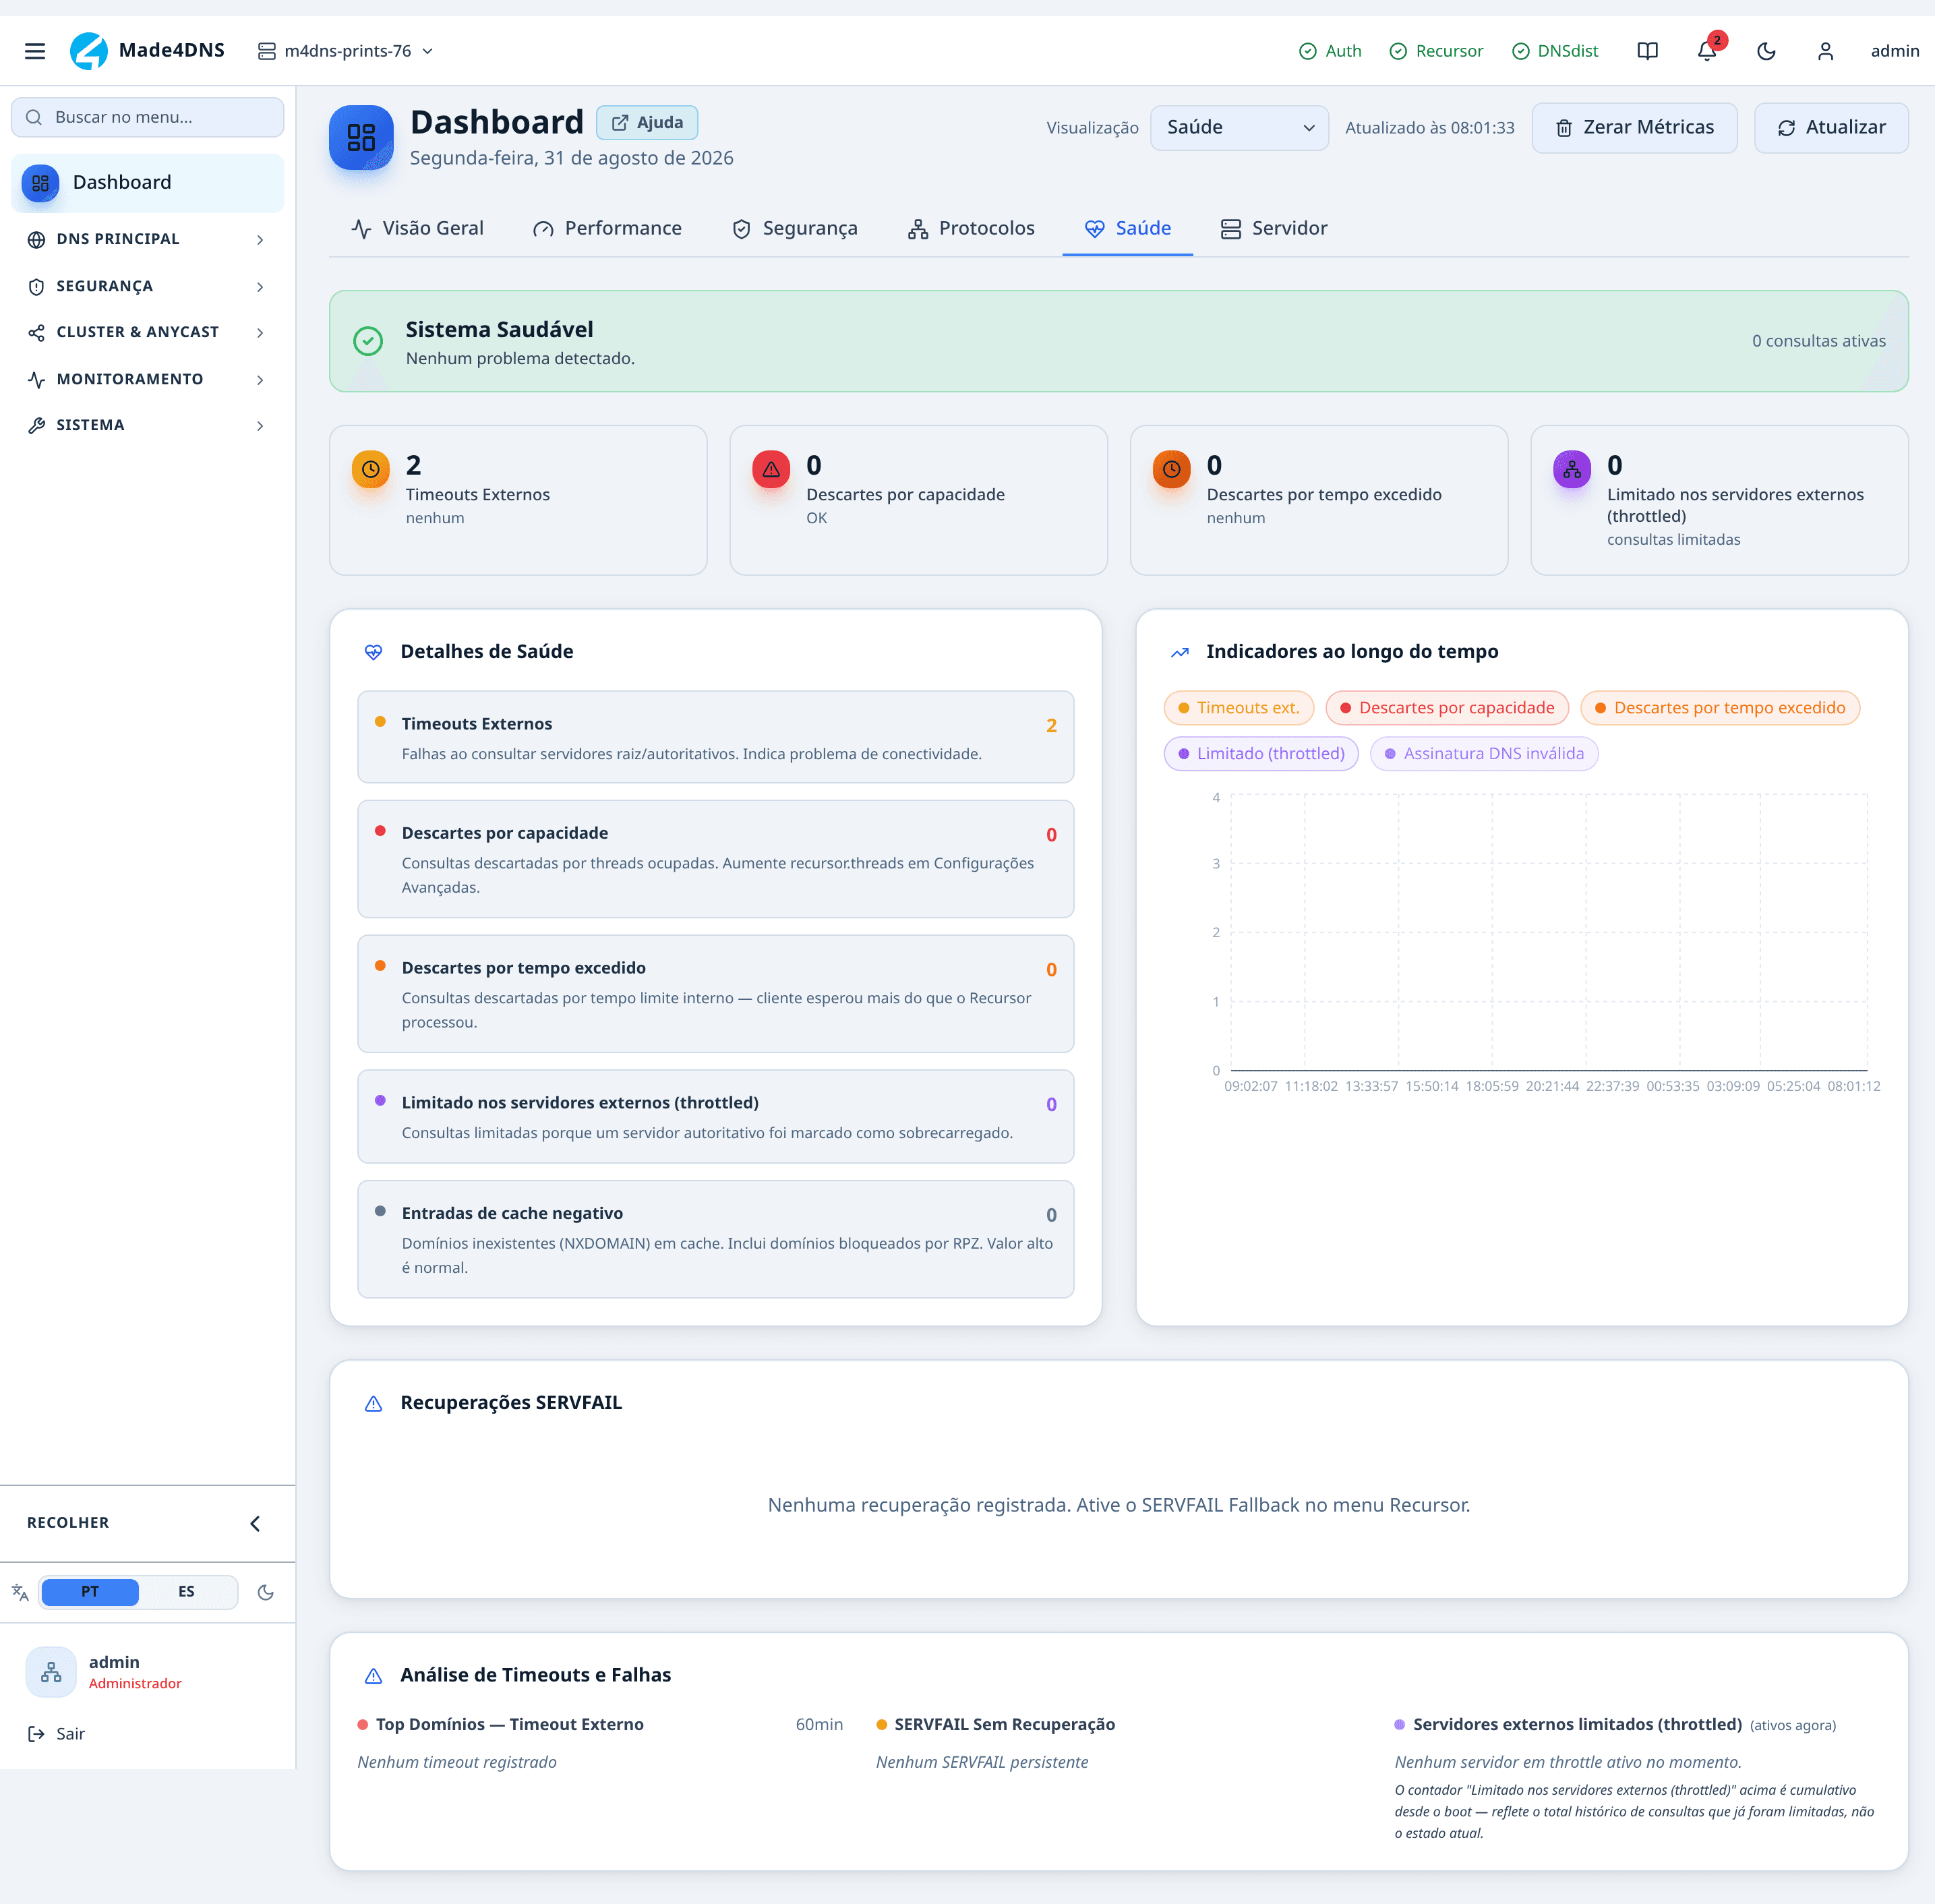
A faixa verde no topo — Sistema Saudável · Nenhum problema detectado — é calculada sobre a variação recente, não sobre o acumulado desde o boot. É isso que faz dela um indicador de agora, e não do mês inteiro.
Logo abaixo, os quatro contadores. Repare que cada um traz a própria legenda em vez de só um número: Timeouts Externos 1 · nenhum, Descartes por capacidade 0 · OK. Um timeout externo isolado é ruído da internet; descarte por capacidade acima de zero é consulta perdida e merece ação imediata.
O bloco Detalhes de Saúde, à esquerda, explica cada contador na própria tela — inclusive
para onde ir: o texto de Descartes por capacidade diz literalmente para aumentar
recursor.threads. E o gráfico Indicadores ao longo do tempo, à direita, é o que separa
"apareceu agora" de "está assim desde sempre".
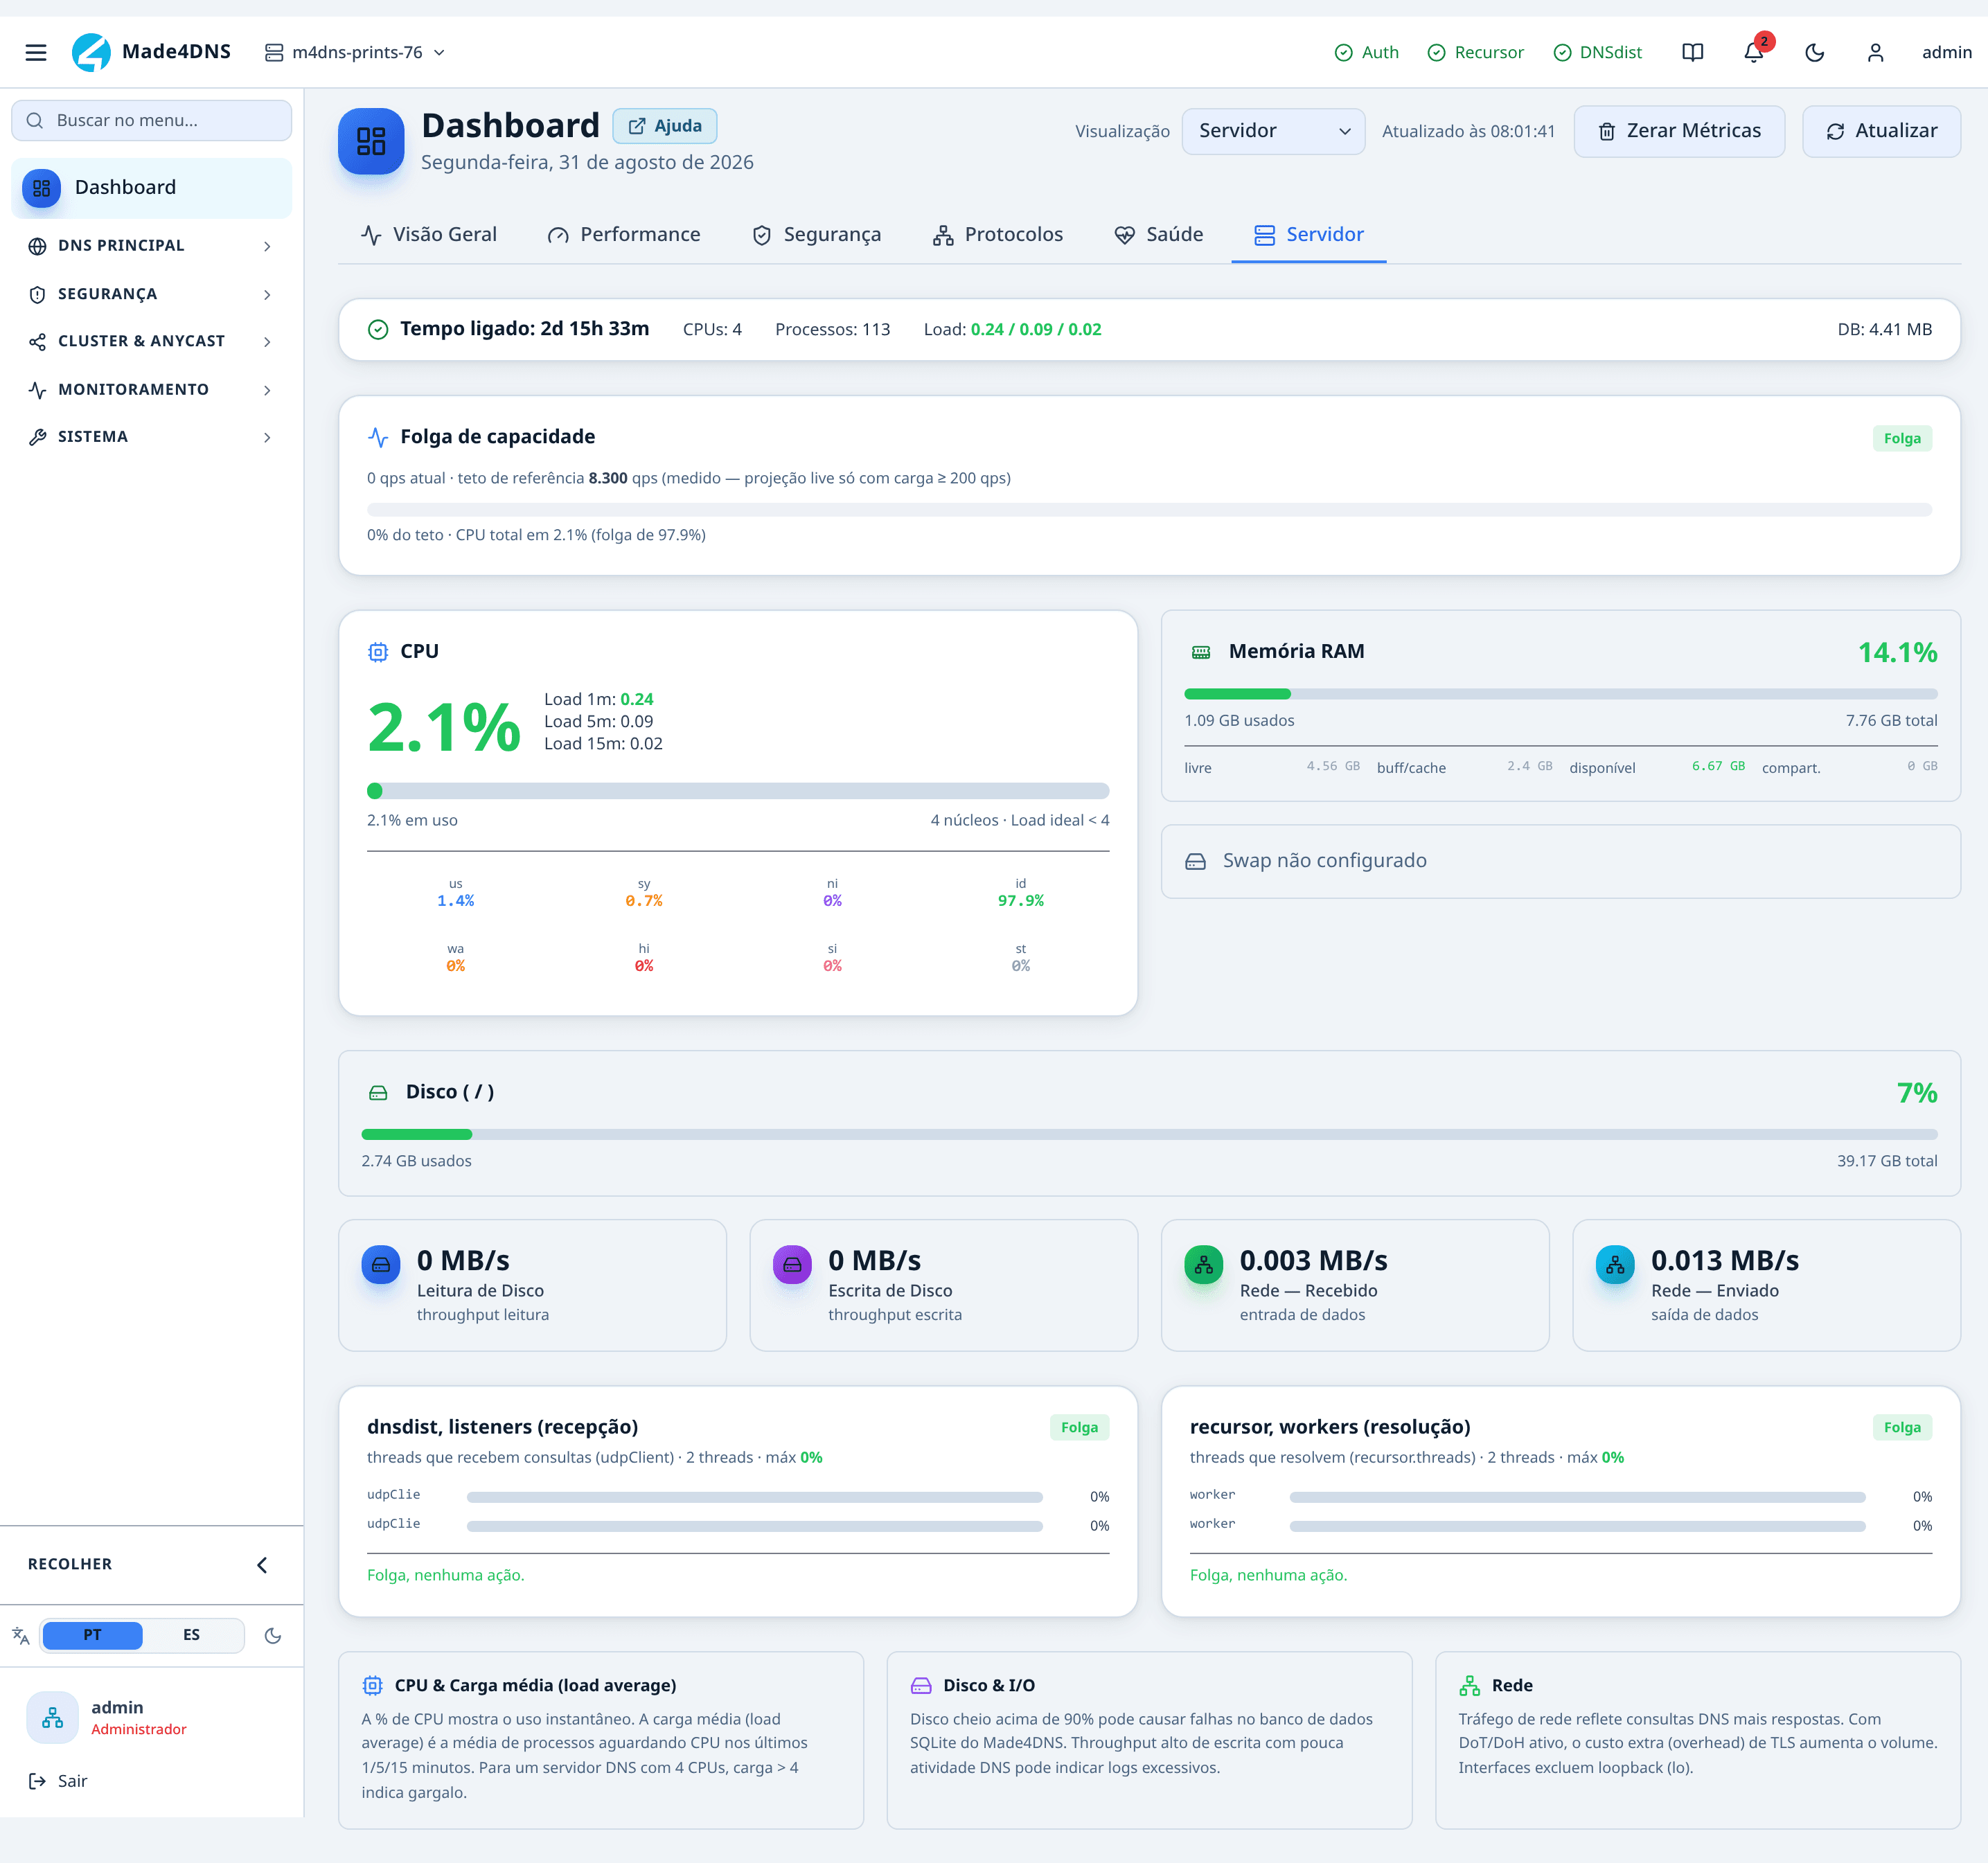
A linha do topo dá o contexto em cinco números: Tempo ligado 20d 23h 48m, CPUs: 4, Load 0.47 / 0.30 / 0.19. Compare a carga média com o número de processadores — carga acima do número de núcleos é gargalo, e aqui ela está bem abaixo.
O bloco Folga de capacidade é o mais útil da aba, e a tela mostra a conta inteira: 386,8
qps atual · teto estimado 1.465 qps, com a fórmula ao lado — qps ÷ CPU total × 100. Daí sai
o 26% do teto e a etiqueta verde Folga.
Os quatro medidores abaixo são a rotina diária de dez segundos: CPU 26.4%, RAM 13.9%, Swap 0%, Disco 7.4%. Swap acima de zero e disco acima de 90% são as duas linhas que estragam o dia — a primeira derruba o acerto de cache, a segunda pode causar falha no banco.
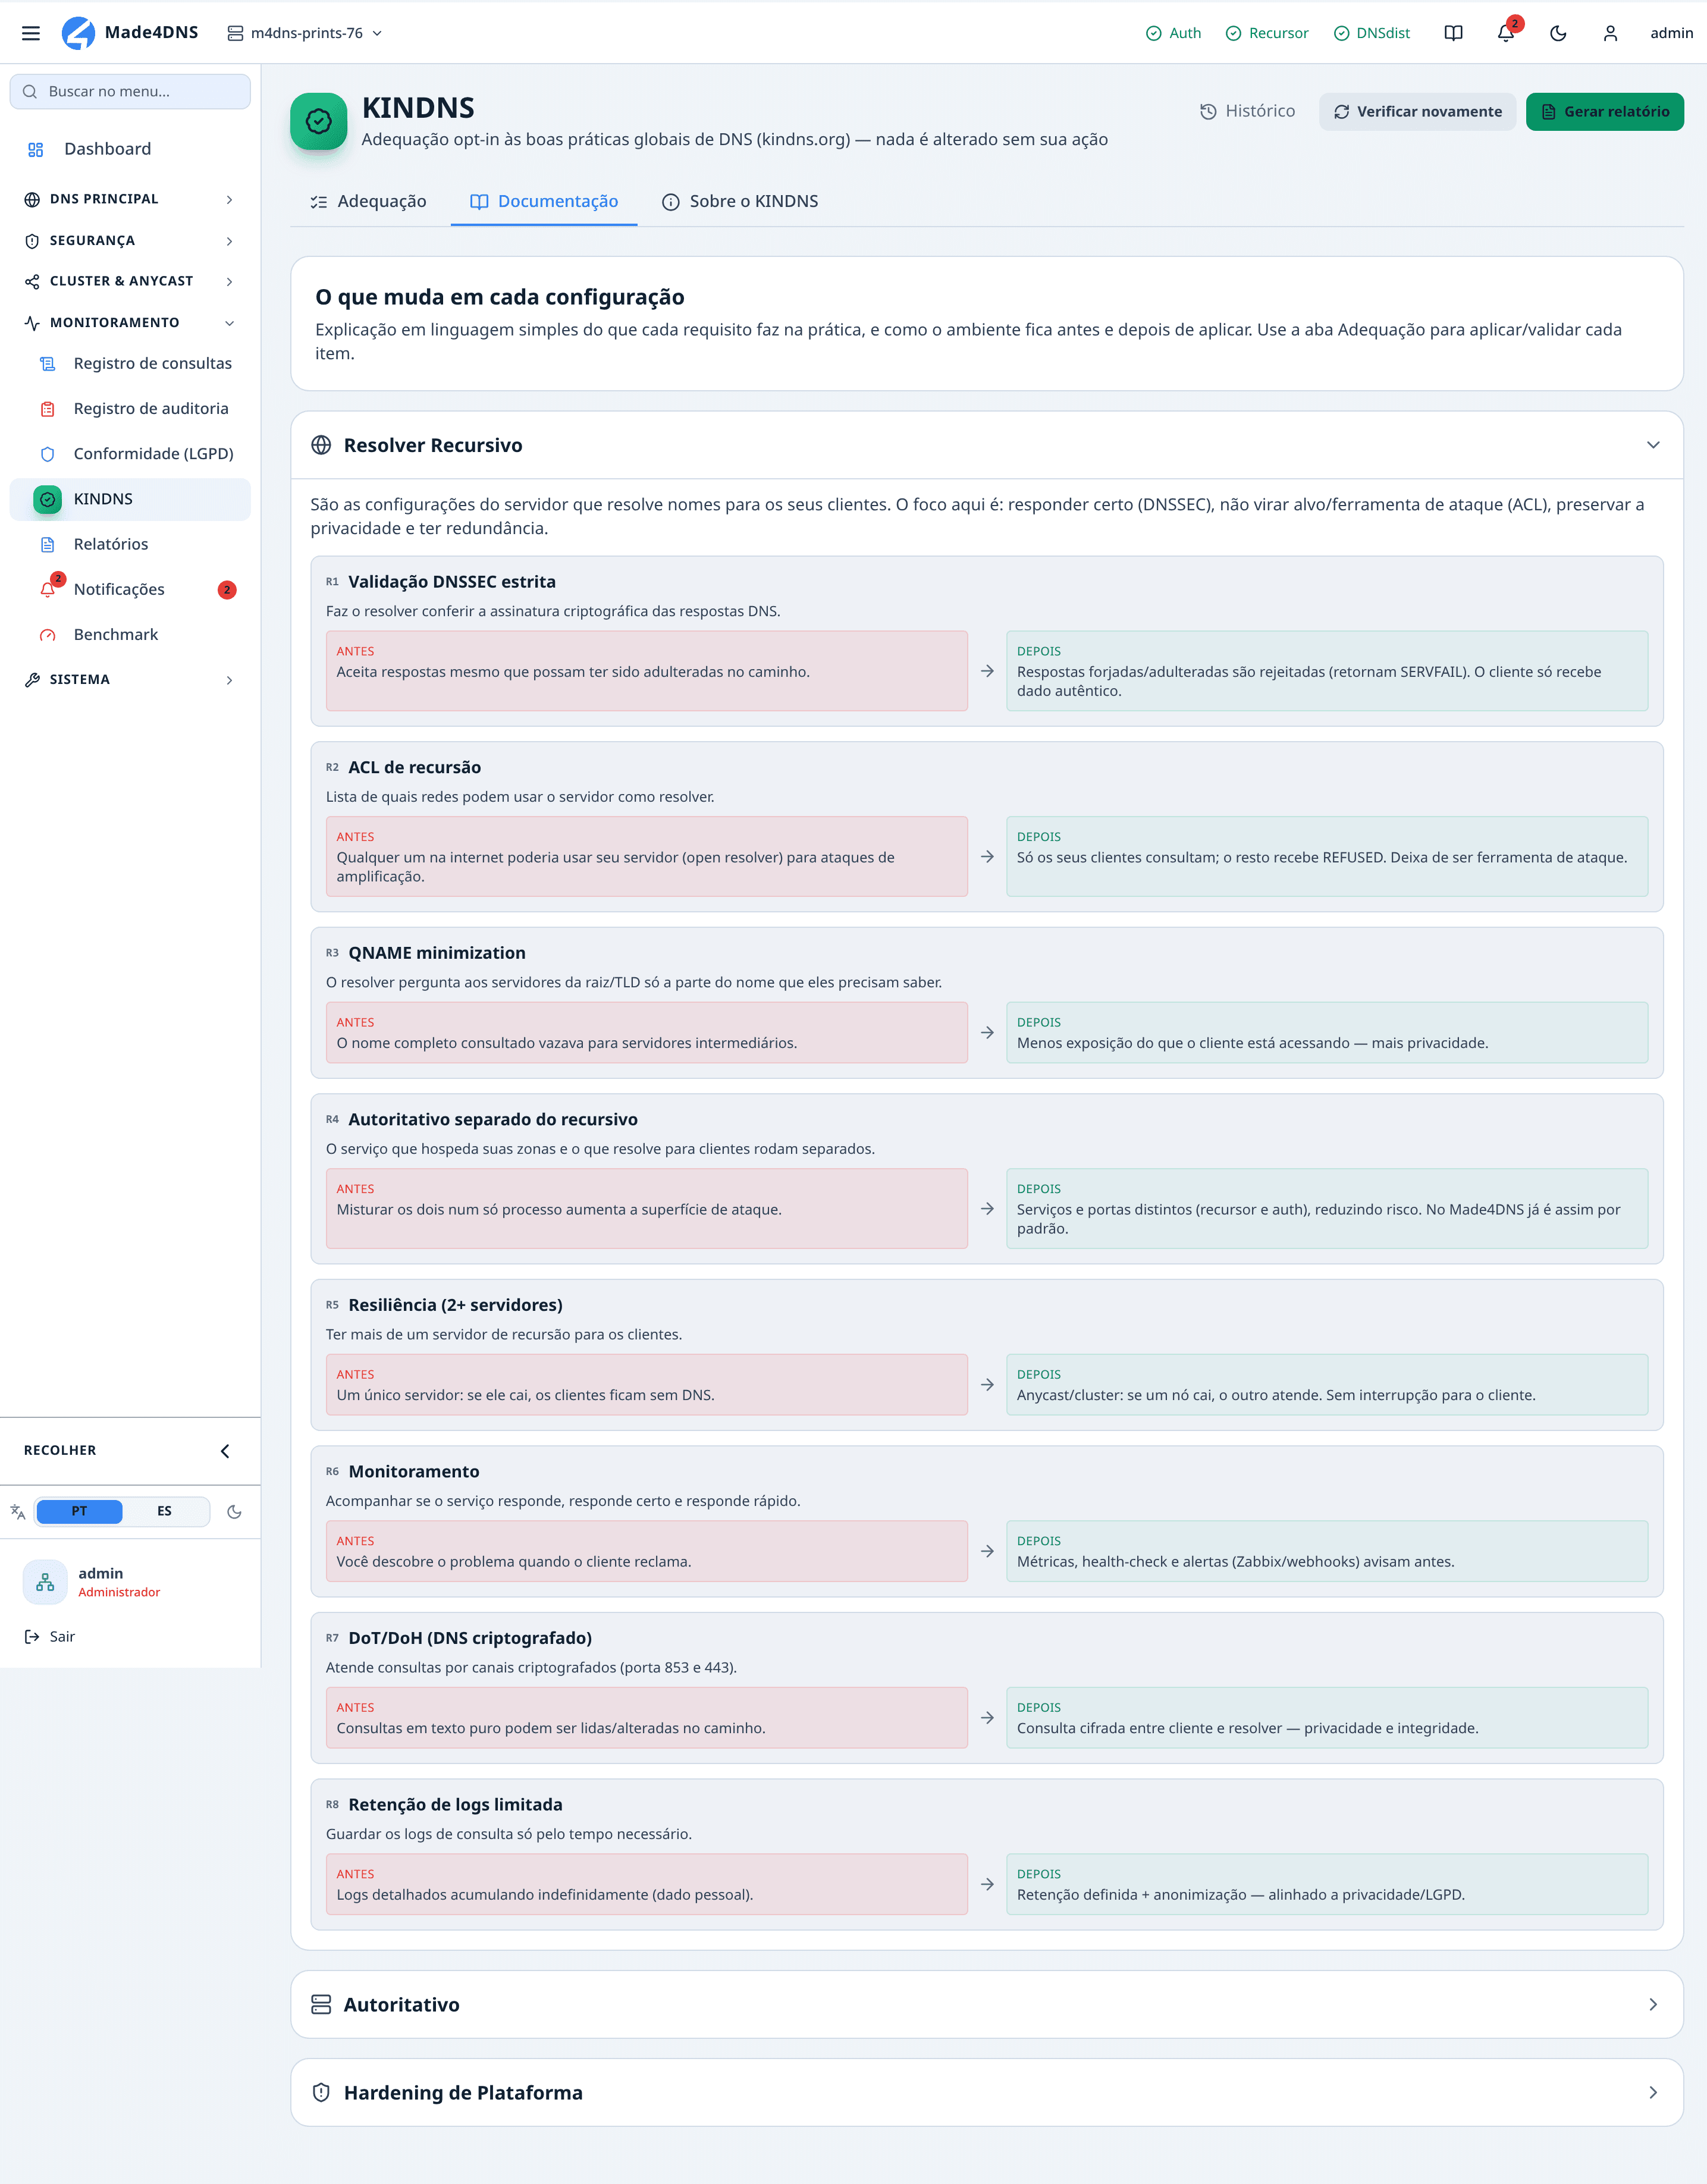
Monitoramento → KINDNS, aba Adequação. O placar no topo — 18 de 23 requisitos aplicáveis
atendidos · 5 parciais · 0 pendentes — e a barra verde/âmbar são o resumo; a lista abaixo é
onde está a informação.
Cada item traz o selo à esquerda (ATENDE ou PARCIAL) e, à direita, como ele está satisfeito: Aplicado quando o produto configurou, Atestado quando é uma declaração sua que o produto não tem como verificar sozinho — caso do R5, resiliência com 2+ servidores.
O subtítulo da tela é a garantia: nada é alterado sem sua ação. É leitura pura. O resultado guardado é o do último exame, então clique em Verificar novamente depois de mudar configuração — senão você está lendo uma foto antiga.
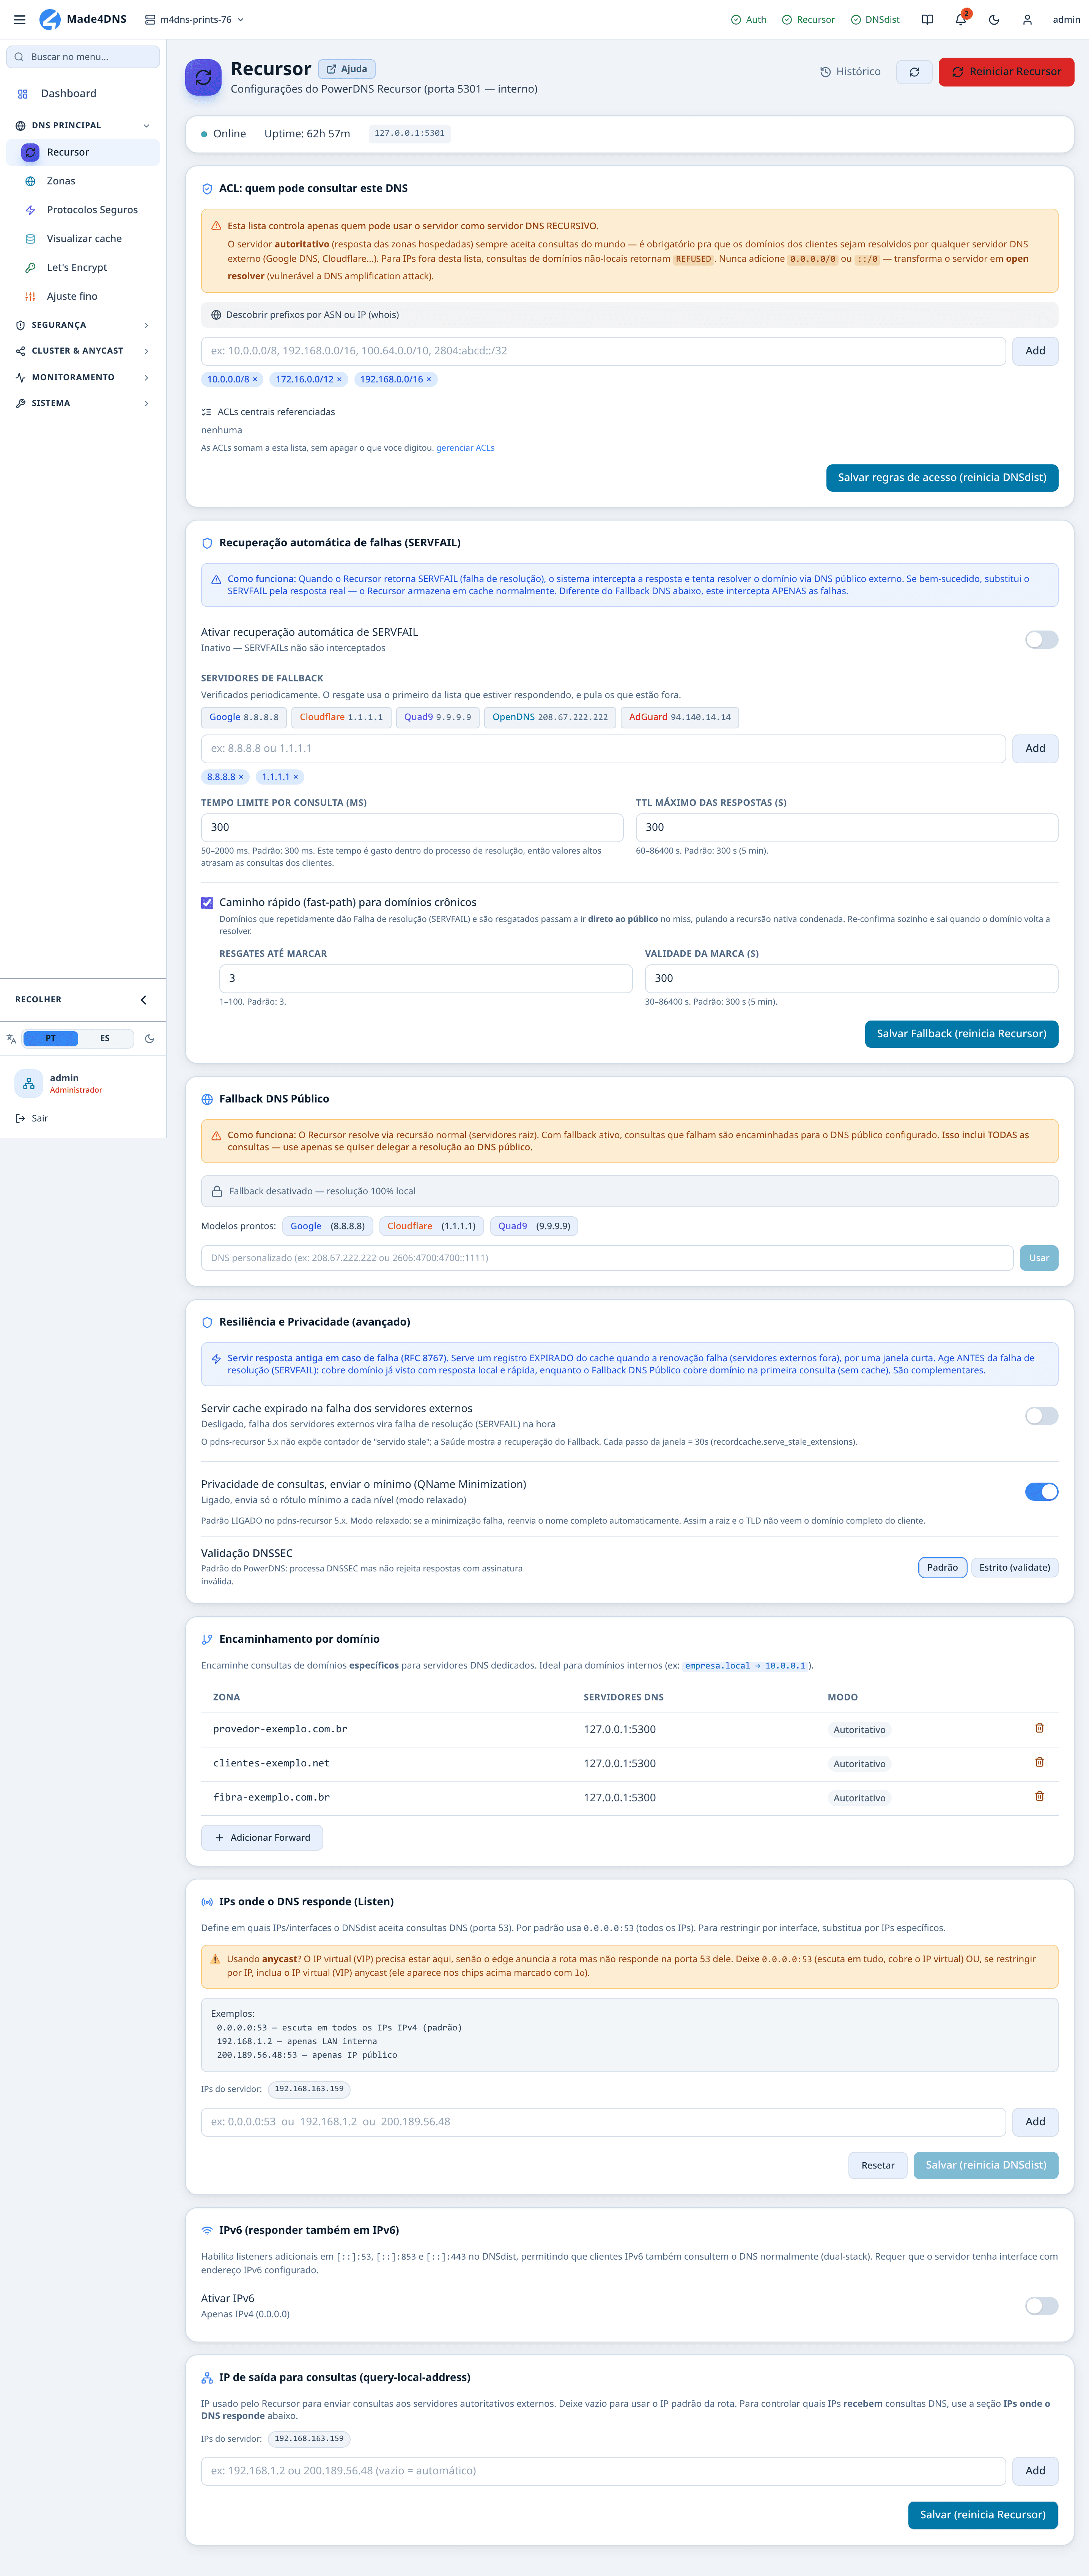
DNS principal → Recursor. Só intercepta as falhas — é o de menor impacto, e o primeiro a
considerar. Vem desligado de fábrica, e a tela diz o estado por extenso: Inativo — SERVFAILs
não são interceptados.
A caixa azul explica a diferença que mais confunde: este bloco intercepta APENAS as falhas,
ao contrário do Fallback DNS logo abaixo. Os servidores públicos configurados —
8.8.8.8, 1.1.1.1, 9.9.9.9 — são tentados em ordem até o primeiro que responder, com
atalhos prontos para Google, Cloudflare, Quad9, OpenDNS e AdGuard.
O botão é honesto sobre o preço: Salvar Fallback (reinicia Recursor) — 1 a 2 segundos, com a camada de entrada continuando a servir cache no intervalo.
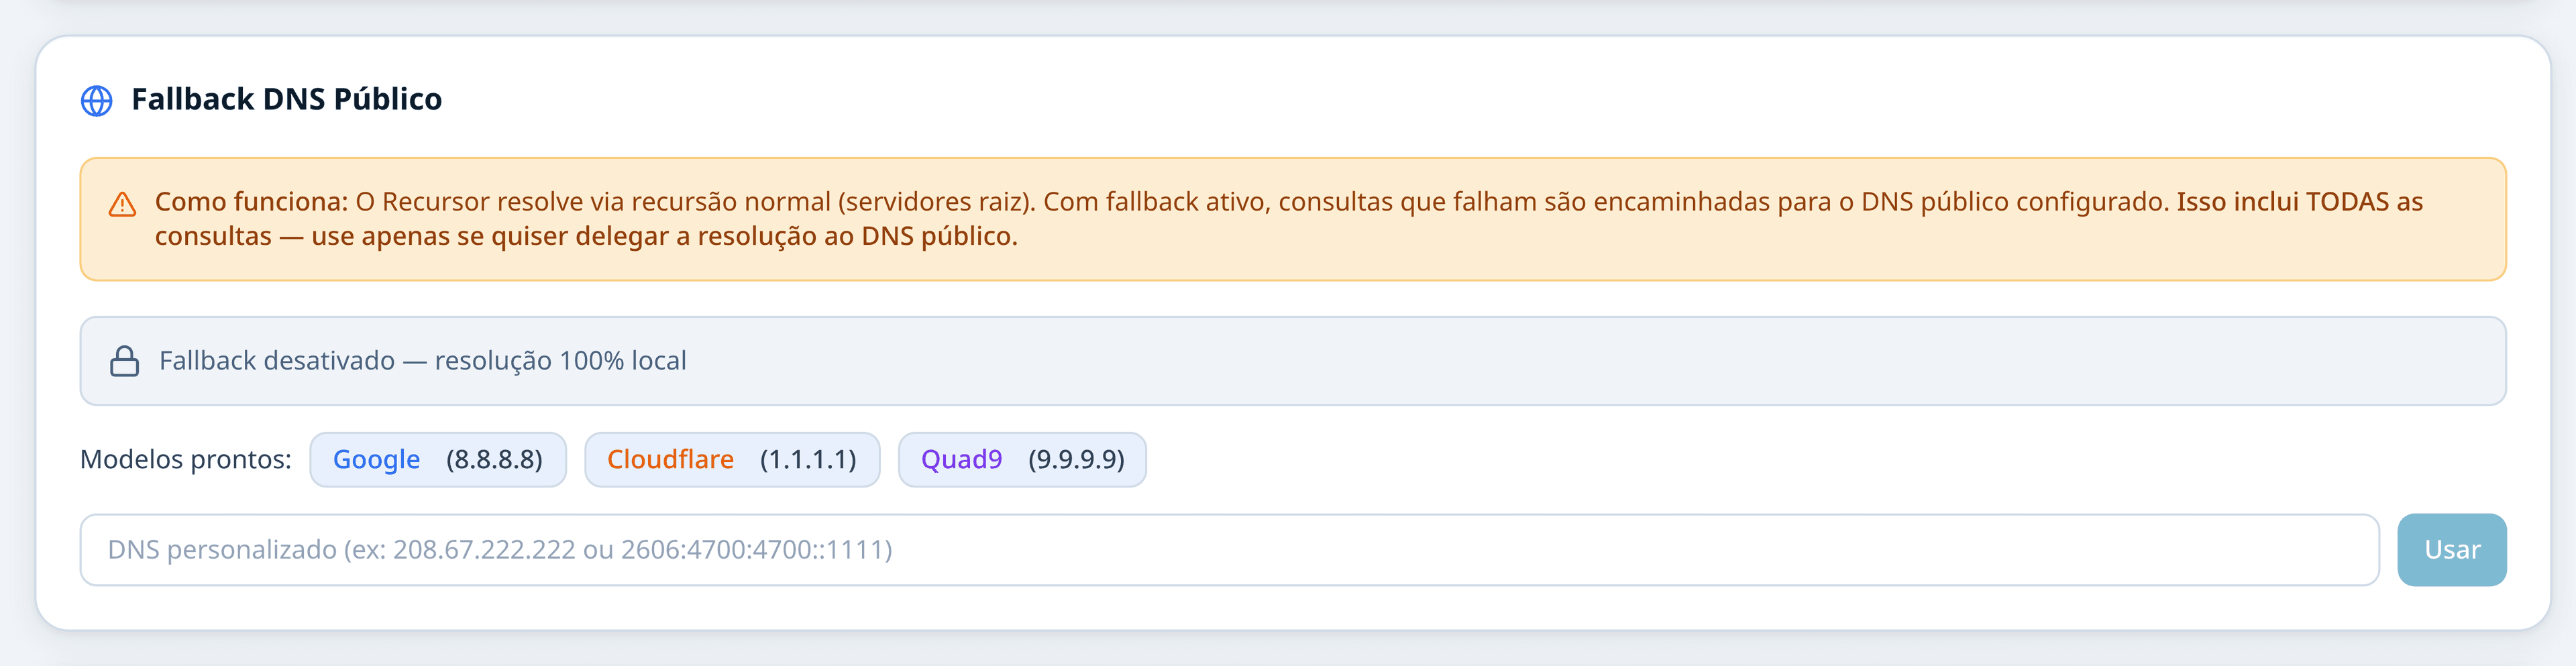
Este manda tudo para fora, e a caixa âmbar não disfarça: Isso inclui TODAS as consultas — use apenas se quiser delegar a resolução ao DNS público.
Enquanto está desligado, a tela mostra literalmente Fallback desativado — resolução 100% local. É essa a frase que você confere depois do incidente, para saber que desfez.
Ligar troca a resolução própria por um intermediário: some a privacidade dos assinantes, some a independência e soma latência. Se o seu contrato ou a regulação do seu país dizem alguma coisa sobre a quem os dados de navegação podem ser expostos, a decisão vem antes do clique.
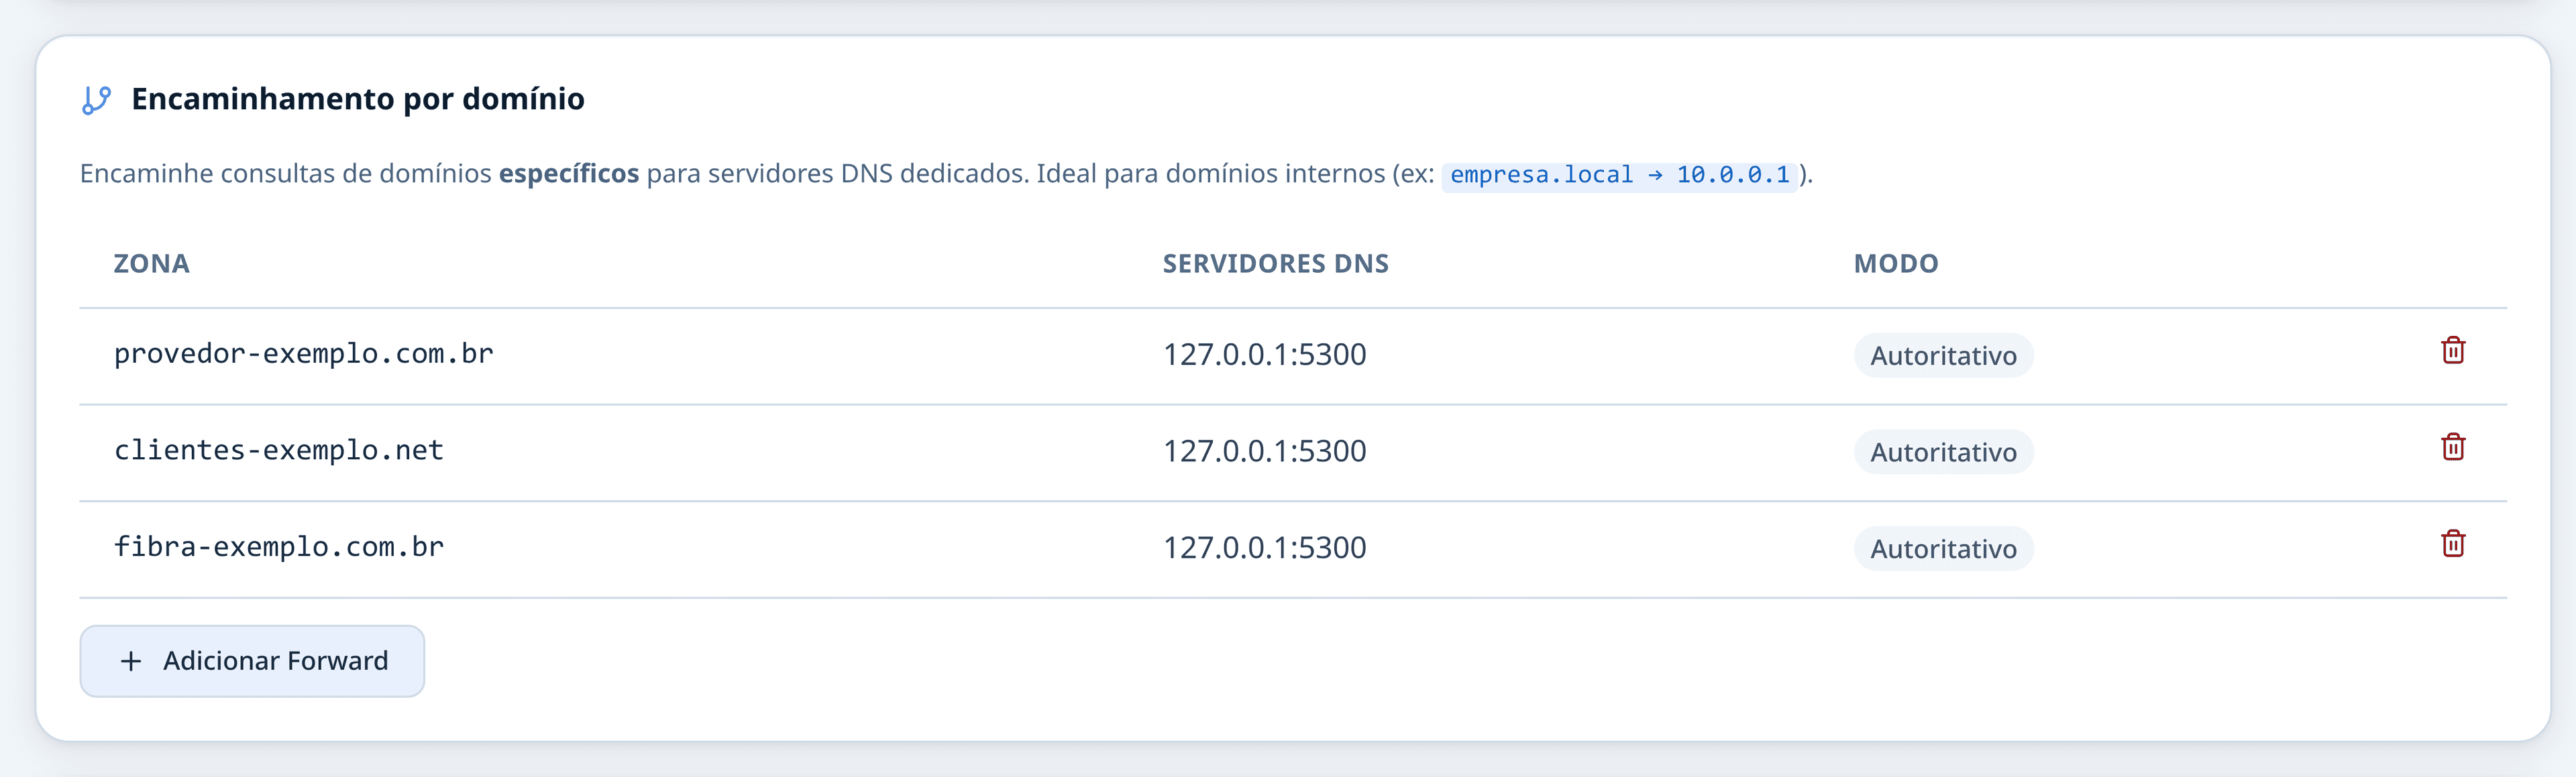
A resposta proporcional quando o problema é um destino só. A tabela tem três colunas — Zona, Servidores DNS e Modo — e cada linha desvia exatamente aquele domínio, sem tocar no resto da resolução.
O marcador de Modo (Autoritativo ou Recursivo) diz como o destino deve ser tratado. Este
print mostra também o outro uso da seção, o mais comum no dia a dia: domínios internos como
slavetest.lab e provedor-exemplo.com.br apontando para um servidor local em
127.0.0.1:5300.
E mostra a armadilha da seção: oito entradas acumuladas. Nenhuma delas se remove sozinha. Entradas antigas continuam desviando um domínio muito depois de o problema ter acabado — revise a lista de tempos em tempos, e apague o que já não faz sentido pelo ícone à direita.
A rotina diária
Os selos no topo do Dashboard
Os três serviços da pilha, de relance. Qualquer um fora do verde é o primeiro lugar a olhar, antes de qualquer métrica.
Dashboard → Saúde
O veredito no topo é calculado sobre a variação recente, não sobre o acumulado desde o boot. É o que faz dele um indicador de agora, e não do mês inteiro.
| Veredito | Ação |
|---|---|
| Sistema Saudável | Nada a fazer |
| Atenção Necessária | Tempos esgotados ou descartes por tempo excedido apareceram — investigue a saída de internet |
| Problema Crítico | Houve descarte por falta de capacidade. É perda de consulta, não lentidão |
Os cinco contadores
| Contador | Leitura |
|---|---|
| Timeouts Externos | Falhas ao consultar a internet. Crescendo, o problema é a saída ou a rede |
| Descartes por capacidade | Consultas jogadas fora por falta de threads. Qualquer valor merece ação |
| Descartes por tempo excedido | O cliente desistiu antes de o resolvedor terminar |
| Limitado nos servidores externos | Acumulado desde o boot, não estado atual. Só age se estiver crescendo |
| Entradas de cache negativo | Valor alto é normal — inclui os domínios bloqueados |
Dashboard → Servidor
Folga de capacidade, processador, memória e disco. Duas linhas que valem uma olhada rápida todo dia: disco acima de 90% pode causar falha no banco, e carga média acima do número de processadores indica gargalo.
Notificações
O servidor avisa sozinho sobre coisas que não aparecem em nenhum gráfico — parceiro de cluster sem sincronizar, certificado perto de vencer. Confira Notificações antes que alguém abra chamado.
A atualização automática do Dashboard pausa quando a aba do navegador vai para segundo plano e retoma quando você volta. Números que "pararam de andar" numa janela esquecida aberta não são travamento.
A verificação periódica
O que não muda de um dia para o outro, mas apodrece devagar:
| O que | Onde | Com que frequência |
|---|---|---|
| Conformidade com as boas práticas de DNS | Verificar a conformidade KINDNS | Depois de qualquer mudança relevante, e periodicamente |
| O que mudou no produto, e quem mudou | Registro de auditoria | Semanal |
| Backup existindo e recente | Backup | Semanal |
| Validade dos certificados | Let's Encrypt e a ferramenta SSL/TLS | Mensal |
| Capacidade ainda folgada para a base atual | Medir a capacidade | A cada crescimento relevante da base |
A checagem KINDNS não altera nada
Ela é opt-in e somente leitura: olha a configuração e reporta item a item. O resultado guardado é o do último exame, então rode de novo depois de mudar configuração — senão você está lendo uma foto antiga.
Quando a resolução está degradada por causa da rede
O quadro é este: o servidor está de pé, o processador com folga, e mesmo assim os assinantes reclamam. Os sinais que confirmam:
| Sinal | Onde |
|---|---|
| Timeouts Externos crescendo, com processador folgado | Dashboard → Saúde |
| Histograma da entrada bom, de resolução acima de 1 s | Dashboard → Performance |
| Lista de domínios com falha de resolução crescendo | Dashboard → Segurança |
| Muitos domínios diferentes afetados ao mesmo tempo | Relato do suporte, e o Diag. Autoritativo apontando roteamento ou firewall |
Confirme a causa antes de aplicar paliativo — o roteiro está em diagnosticar um domínio que não resolve. Um paliativo sobre a causa errada esconde o problema sem resolver nada.
Os três paliativos, e o preço de cada um
Todos ficam em DNS principal → Recursor. Salvar qualquer um deles reinicia o Recursor — de 1 a 2 segundos, com a camada de entrada continuando a servir cache durante o intervalo.
| Paliativo | Alcance | Custo | Reverter |
|---|---|---|---|
| Recuperação automática de falhas (SERVFAIL) | Só as consultas que falhariam | Baixo: mantém a resolução própria | Desligar o interruptor |
| Fallback DNS Público | Todas as consultas | Alto: privacidade e independência | Remover o encaminhamento |
| Encaminhamento por domínio | Só os domínios que você listar | Baixo, e limitado ao que foi listado | Remover a entrada |
1. Recuperação automática de falhas (SERVFAIL)
É o de menor impacto, e o primeiro a considerar. Vem desligado de fábrica.
Ligado, ele intercepta apenas as falhas: quando a resolução resultaria em falha de resolução (SERVFAIL), a consulta é refeita em DNS públicos configurados. Dando certo, o assinante recebe a resposta real, e ela é guardada em cache normalmente. A resolução própria continua sendo o caminho principal — o público só entra quando o caminho normal já falhou.
O que dá para ajustar:
| Campo | Padrão | O que muda |
|---|---|---|
| Servidores de Fallback | 8.8.8.8, 1.1.1.1, 9.9.9.9 | Tentados em ordem até o primeiro que responder. Há atalhos para Google, Cloudflare, Quad9, OpenDNS e AdGuard |
| Timeout por servidor | 2 s (1 a 30) | Quanto cada público tem antes de cair para o próximo |
| TTL máximo das respostas | 300 s (60 a 86400) | Teto de cache das respostas resgatadas |
| Caminho rápido para domínios crônicos | ligado | Domínios que falham repetidamente passam a ir direto ao público. Sai sozinho quando o domínio volta a resolver |
| Resgates até marcar | 3 (1 a 100) | Quantos resgates até marcar o domínio como crônico |
| Validade da marca | 300 s | Quanto a marca dura antes de ser reavaliada |
Ligando esta função, os tempos de espera recomendados em Ajuste fino mudam: 800 a 1000 ms por servidor e 3000 ms no total. Sem esse ajuste, o resgate demora demais para entrar em ação e o assinante sente a espera do mesmo jeito.
O que ele custa: só os nomes que falharam saem para o DNS público. É pouco, mas não é zero. E, como esta função esconde o sintoma, o acompanhamento passa a ser obrigatório: o bloco de recuperações e a lista de domínios em caminho rápido, na aba Saúde, viram o seu inventário do que ainda está quebrado.
2. Fallback DNS Público
É o mais forte e o de maior consequência. Ligado, todas as consultas passam a ser encaminhadas ao DNS público escolhido, e o servidor deixa de resolver pela raiz — na prática ele vira, em boa medida, um servidor de cache na frente de um resolvedor de terceiro.
Modelos prontos: Google, Cloudflare e Quad9. Ou um endereço próprio no campo livre. Enquanto está desligado, a tela mostra literalmente resolução 100% local; ligado, mostra os servidores em uso e o botão de remover.
A consequência não é técnica, é de privacidade
Com esta opção ligada, o tráfego de consultas dos seus assinantes passa a ser visto por um terceiro — todo ele, não só o que falhou. Some a isso a perda da resolução independente e uma latência maior por depender de um intermediário.
Se o seu contrato, a sua política ou a regulação do seu país dizem alguma coisa sobre a quem os dados de navegação dos assinantes podem ser expostos, este é o botão que precisa de decisão antes do clique, não depois.
Quando ele se justifica: incidente amplo, com a resolução própria comprometida e a base inteira afetada, por uma janela curta e com hora para acabar. Não como configuração de rotina.
As zonas que você criou no produto continuam sendo respondidas localmente: cada uma tem o próprio encaminhamento para o servidor autoritativo desta máquina, e ele é mais específico que o encaminhamento da raiz. O que vai para o público é o resto.
3. Encaminhamento por domínio
Quando o problema é um destino só — um domínio grande cujos autoritativos você não alcança — esta é a resposta proporcional. Envia aquele domínio específico para servidores determinados, e deixa todo o resto da resolução intacto.
Cada entrada tem a zona, os servidores de destino e um marcador Recursivo ou Autoritativo. É também o mecanismo usado para domínio interno da empresa apontando para um servidor local.
Em espanhol esta seção chama-se Reenvío condicional. Se você opera nos dois idiomas, é o mesmo lugar.
O que ele custa: quase nada, e o alcance é exatamente o que você listou. A armadilha é a outra: entradas antigas ficam esquecidas na lista e continuam desviando um domínio muito depois de o problema ter acabado. Revise a lista de tempos em tempos.
Uma quarta opção, para outro problema
Servir resposta antiga em caso de falha, na seção de resiliência avançada, entrega a cópia expirada do cache quando a renovação falha porque os autoritativos estão fora do ar. A janela é selecionável: 30 s, 60 s, 120 s ou 300 s.
Ela cobre um caso diferente dos outros três: só funciona para domínio que já esteve no cache. Não ajuda em nome novo. Como a resposta antiga é uma resposta de sucesso, ela não dispara a recuperação automática de falhas — as duas são complementares, não alternativas.
Como decidir
- Um destino só está inalcançável → encaminhamento por domínio.
- Falhas espalhadas, sem padrão claro → recuperação automática de falhas.
- Domínios conhecidos falhando na renovação porque os autoritativos caíram → servir resposta antiga.
- A resolução própria está comprometida e a base inteira está parada → Fallback DNS Público, com hora marcada para sair.
Registre e desfaça
Um paliativo sem registro de saída é uma configuração permanente que ninguém decidiu adotar.
Anote o que foi ligado, quando e por quê. O registro de auditoria guarda a mudança e o autor, mas não guarda o motivo — esse é seu.
Defina quando revisar. Um incidente de rede tem hora para acabar; a configuração que ele motivou também deveria ter.
Ao desfazer, confira a tela: o Fallback DNS Público volta a mostrar resolução 100% local, e a lista de encaminhamentos por domínio volta a ter só o que deveria estar lá.
Em cluster, lembre que a ACL, os encaminhamentos e as políticas de resolução replicam para os parceiros — inclusive o paliativo. Já os IPs de escuta e o IP de saída não replicam: são identidade de cada servidor.
Armadilhas
- Ligar o Fallback DNS Público achando que é a recuperação de falhas. São seções diferentes, com alcances opostos: uma pega só as falhas, a outra pega tudo.
- Deixar o paliativo ligado depois do incidente. Ninguém percebe, porque tudo funciona.
- Aplicar paliativo antes de diagnosticar. O sintoma some e a causa fica.
- Esquecer que a recuperação automática de falhas mascara o diagnóstico. Acompanhe a lista de domínios em caminho rápido.
- Ler o contador de servidores externos limitados como estado atual. Ele é acumulado desde o boot; o estado de agora está na análise no fim da aba Saúde.
- Tratar cache negativo alto como problema. É normal, e inclui os domínios bloqueados.
Onde continuar
| Se | Vá para |
|---|---|
| O sintoma é lentidão, não falha | O servidor está lento? |
| Um domínio específico não resolve | Diagnosticar um domínio que não resolve |
| A máquina está no teto | Medir a capacidade |
| Outro sintoma | Índice de sintomas |