
O servidor está lento?
Responder com número, não com sensação — quais latências olhar, o que é normal e quando o caminho é medir ou ajustar.
"Está lento" é a reclamação mais difícil de tratar porque quase nunca vem com número. Esta página troca a sensação por medida: quais indicadores olhar, em que ordem, e o que é um valor normal em cada um.
O percurso inteiro é leitura, no Dashboard. Nada aqui muda configuração.
Existem duas latências, e elas respondem perguntas diferentes
A latência na entrada é o tempo que o assinante sente. A latência de resolução é só o que desceu ao resolvedor, ou seja, o que o cache não respondeu. Confundir as duas é a origem da maioria dos diagnósticos errados de desempenho.
Onde clicar, passo a passo
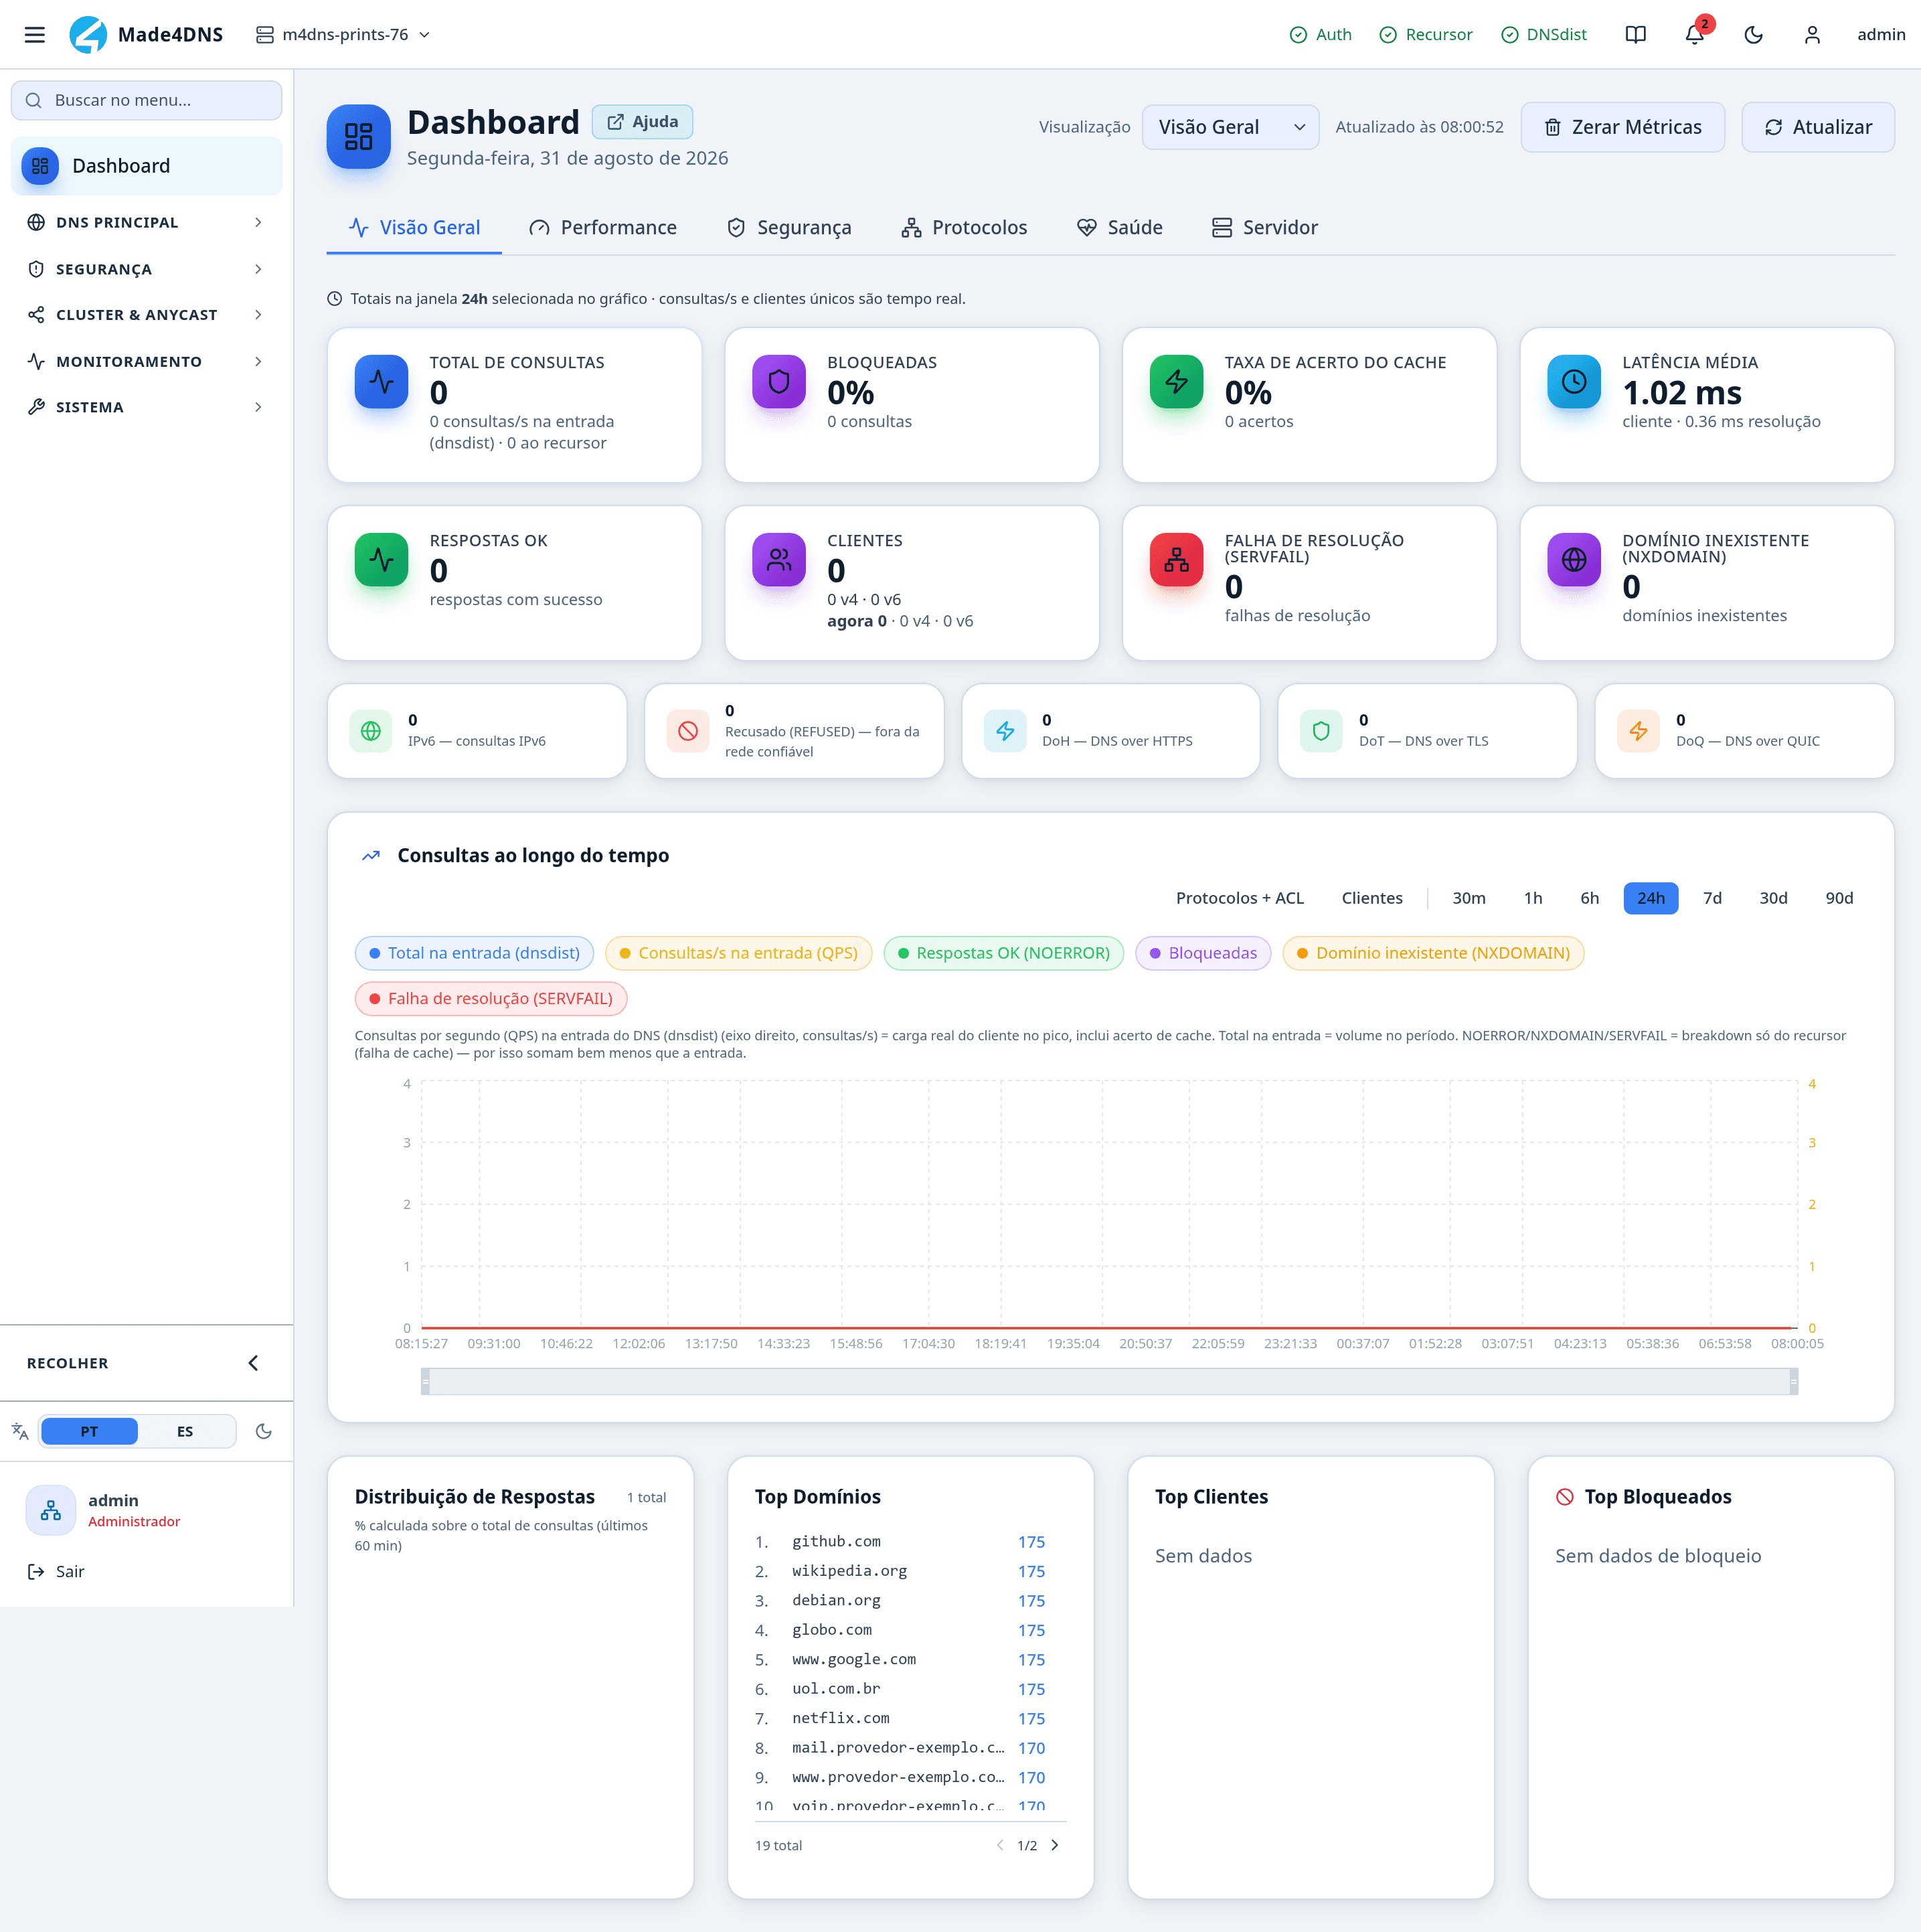
Comece pelos dois cartões que explicam quase toda lentidão:
- Taxa de acerto do cache — 95.7%. O subtítulo separa as camadas: entrada (dnsdist) é esse 95.7%, e recursor 1.2% é outra conta. O primeiro é o que segura a carga; o segundo é naturalmente baixo e não é defeito.
- Latência média — 0 ms, com o subtítulo cliente · 13.28 ms resolução. O número grande é o que o assinante sente; o pequeno é só a falha de cache que desceu ao resolvedor. São perguntas diferentes, e confundi-las é a origem da maioria dos diagnósticos errados.
Note a linha acima dos cartões: Totais na janela 24h selecionada no gráfico. O seletor de janela manda nos acumulados — só consultas/s e os clientes "agora" são tempo real.
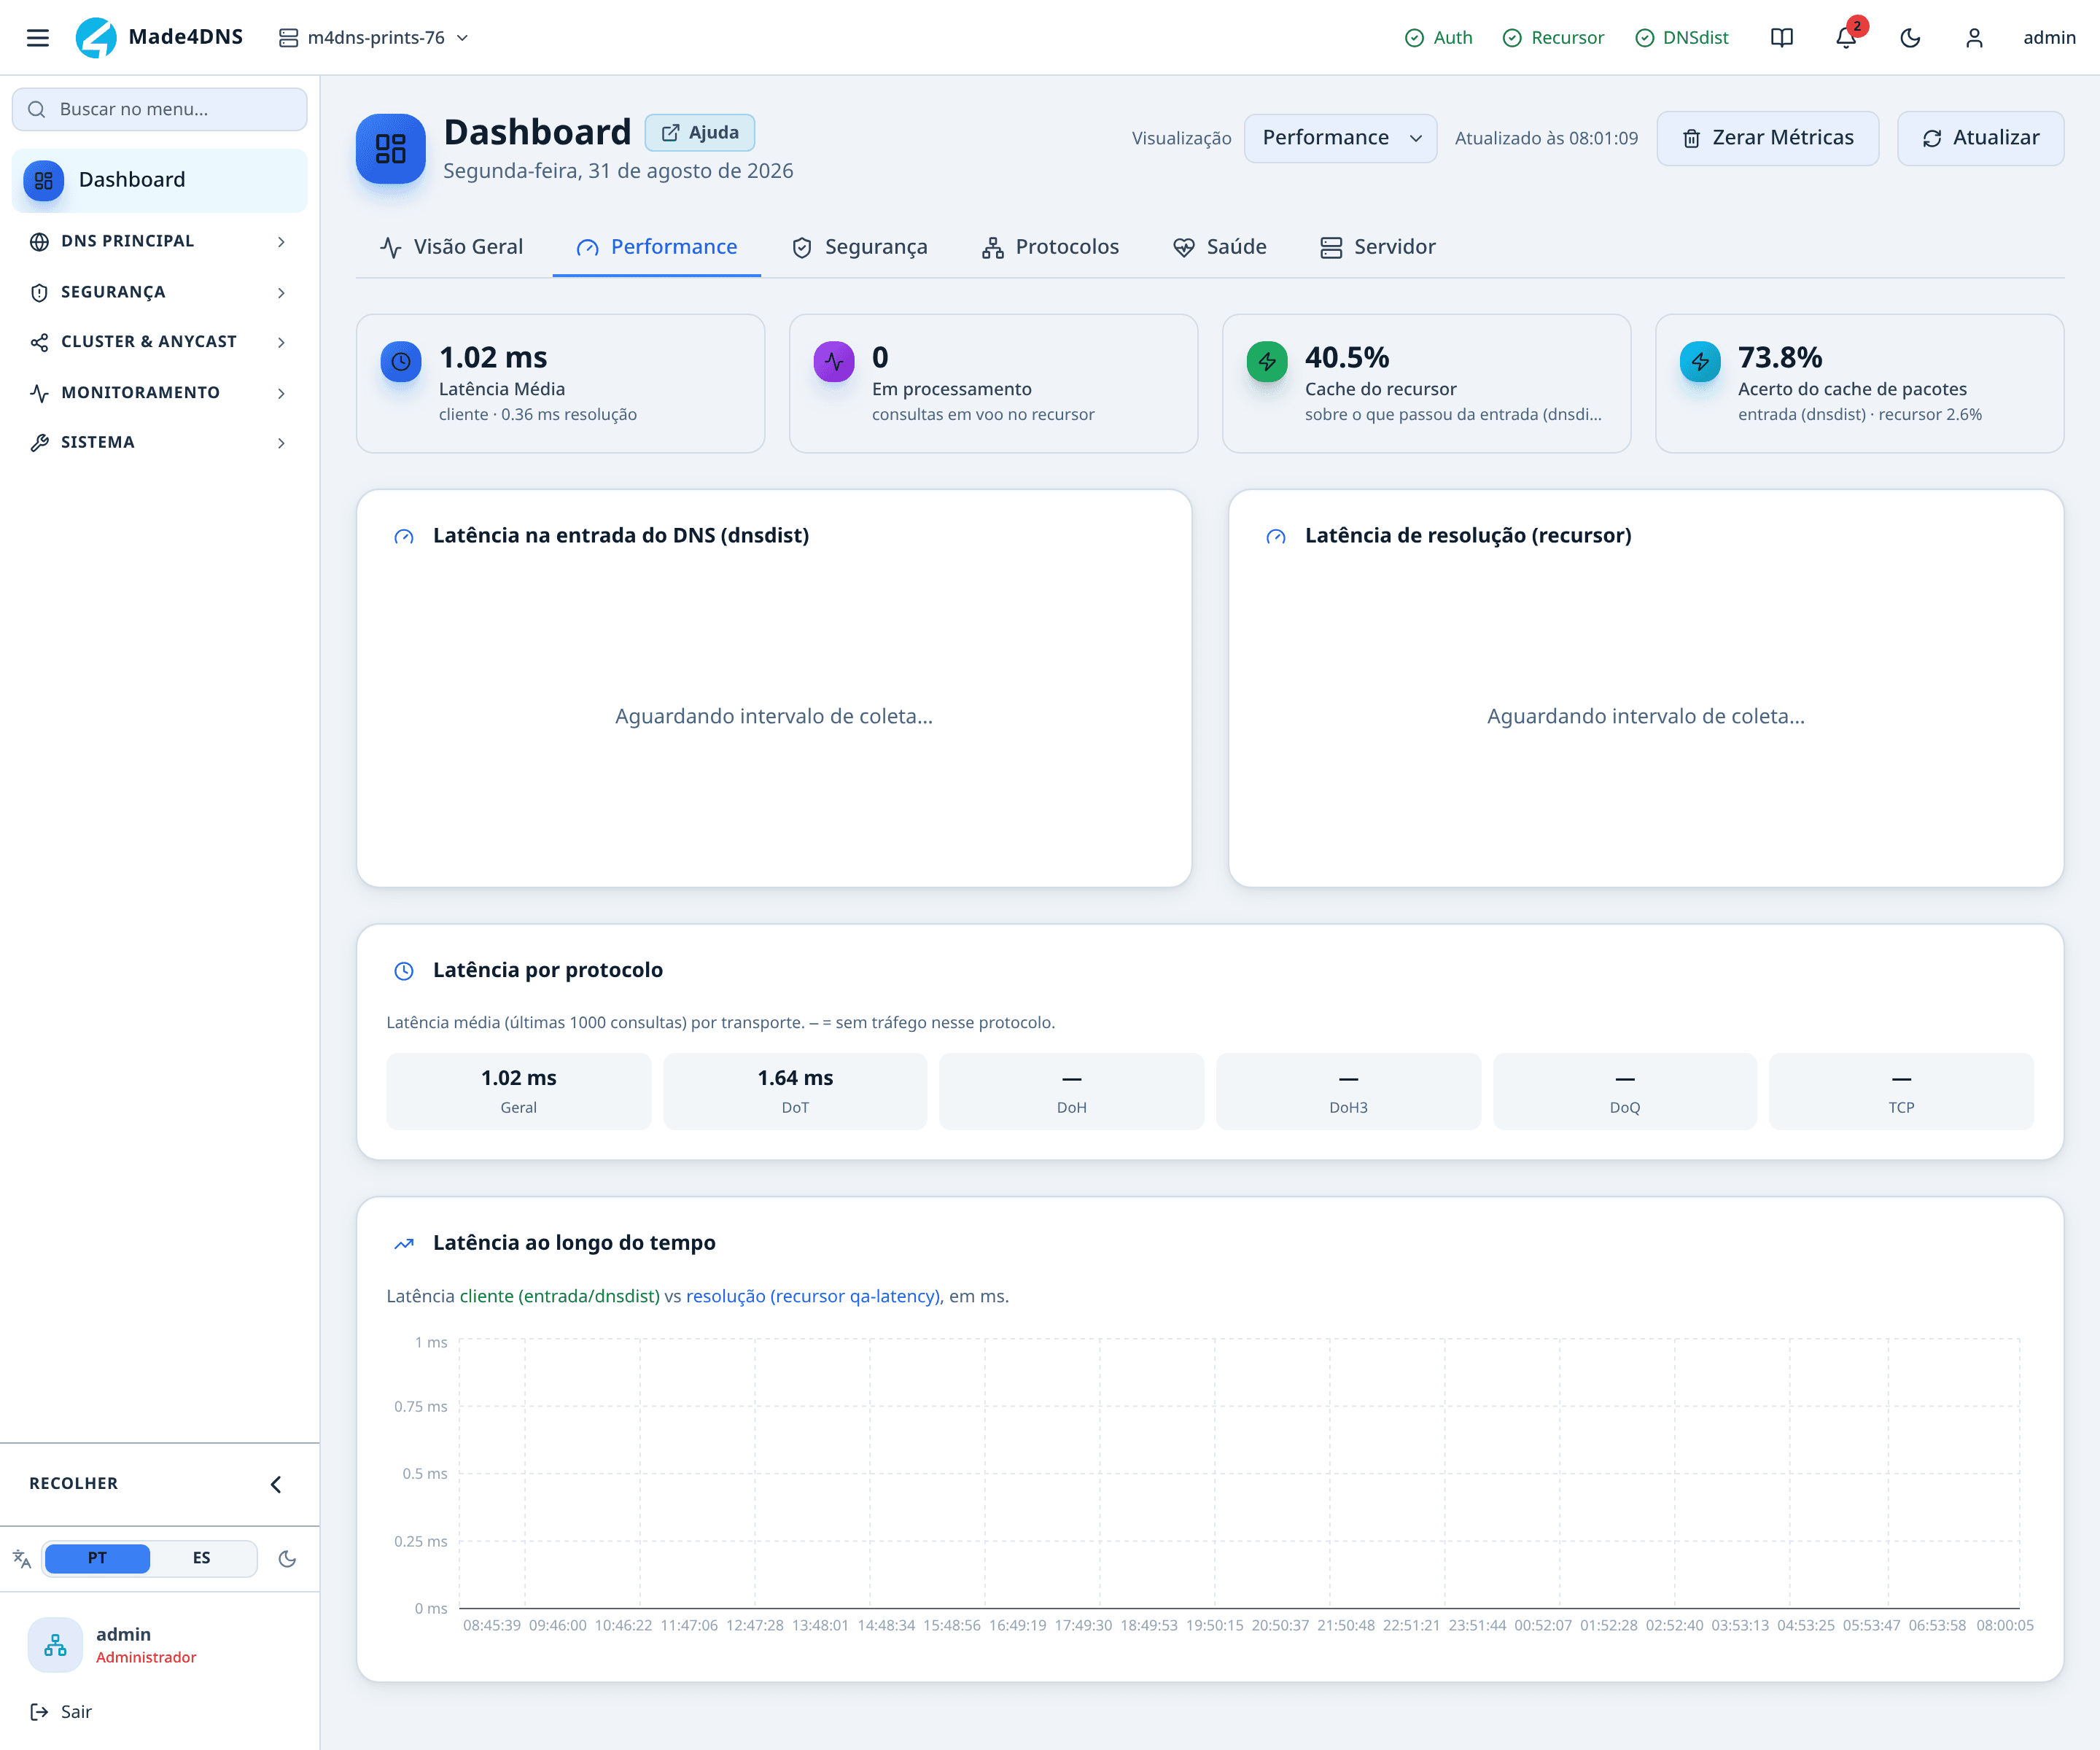
Esta é a tela que decide de quem é o problema. Os dois gráficos usam as mesmas cinco faixas, mas o que é bom em cada um é diferente:
| Gráfico | O que se espera | O que este print mostra |
|---|---|---|
| Latência na entrada do DNS (dnsdist) | Massa em <1ms ou 1–10ms | 72% abaixo de 1 ms, 28% entre 10 e 100 ms |
| Latência de resolução (recursor) | 10–100ms é normal | 100% na faixa de 10 a 100 ms |
A leitura conjunta: a entrada está saudável e a resolução está exatamente onde deveria — este
servidor não está lento. Se a barra da entrada migrasse para 10–100ms, o problema seria
local; se a de resolução migrasse para >1s, seria dos autoritativos da internet.
No topo, o cartão Em processamento mostra 5. Ele não mede volume, mede saturação: perto de zero é saudável, centenas ou milhares significam fila.
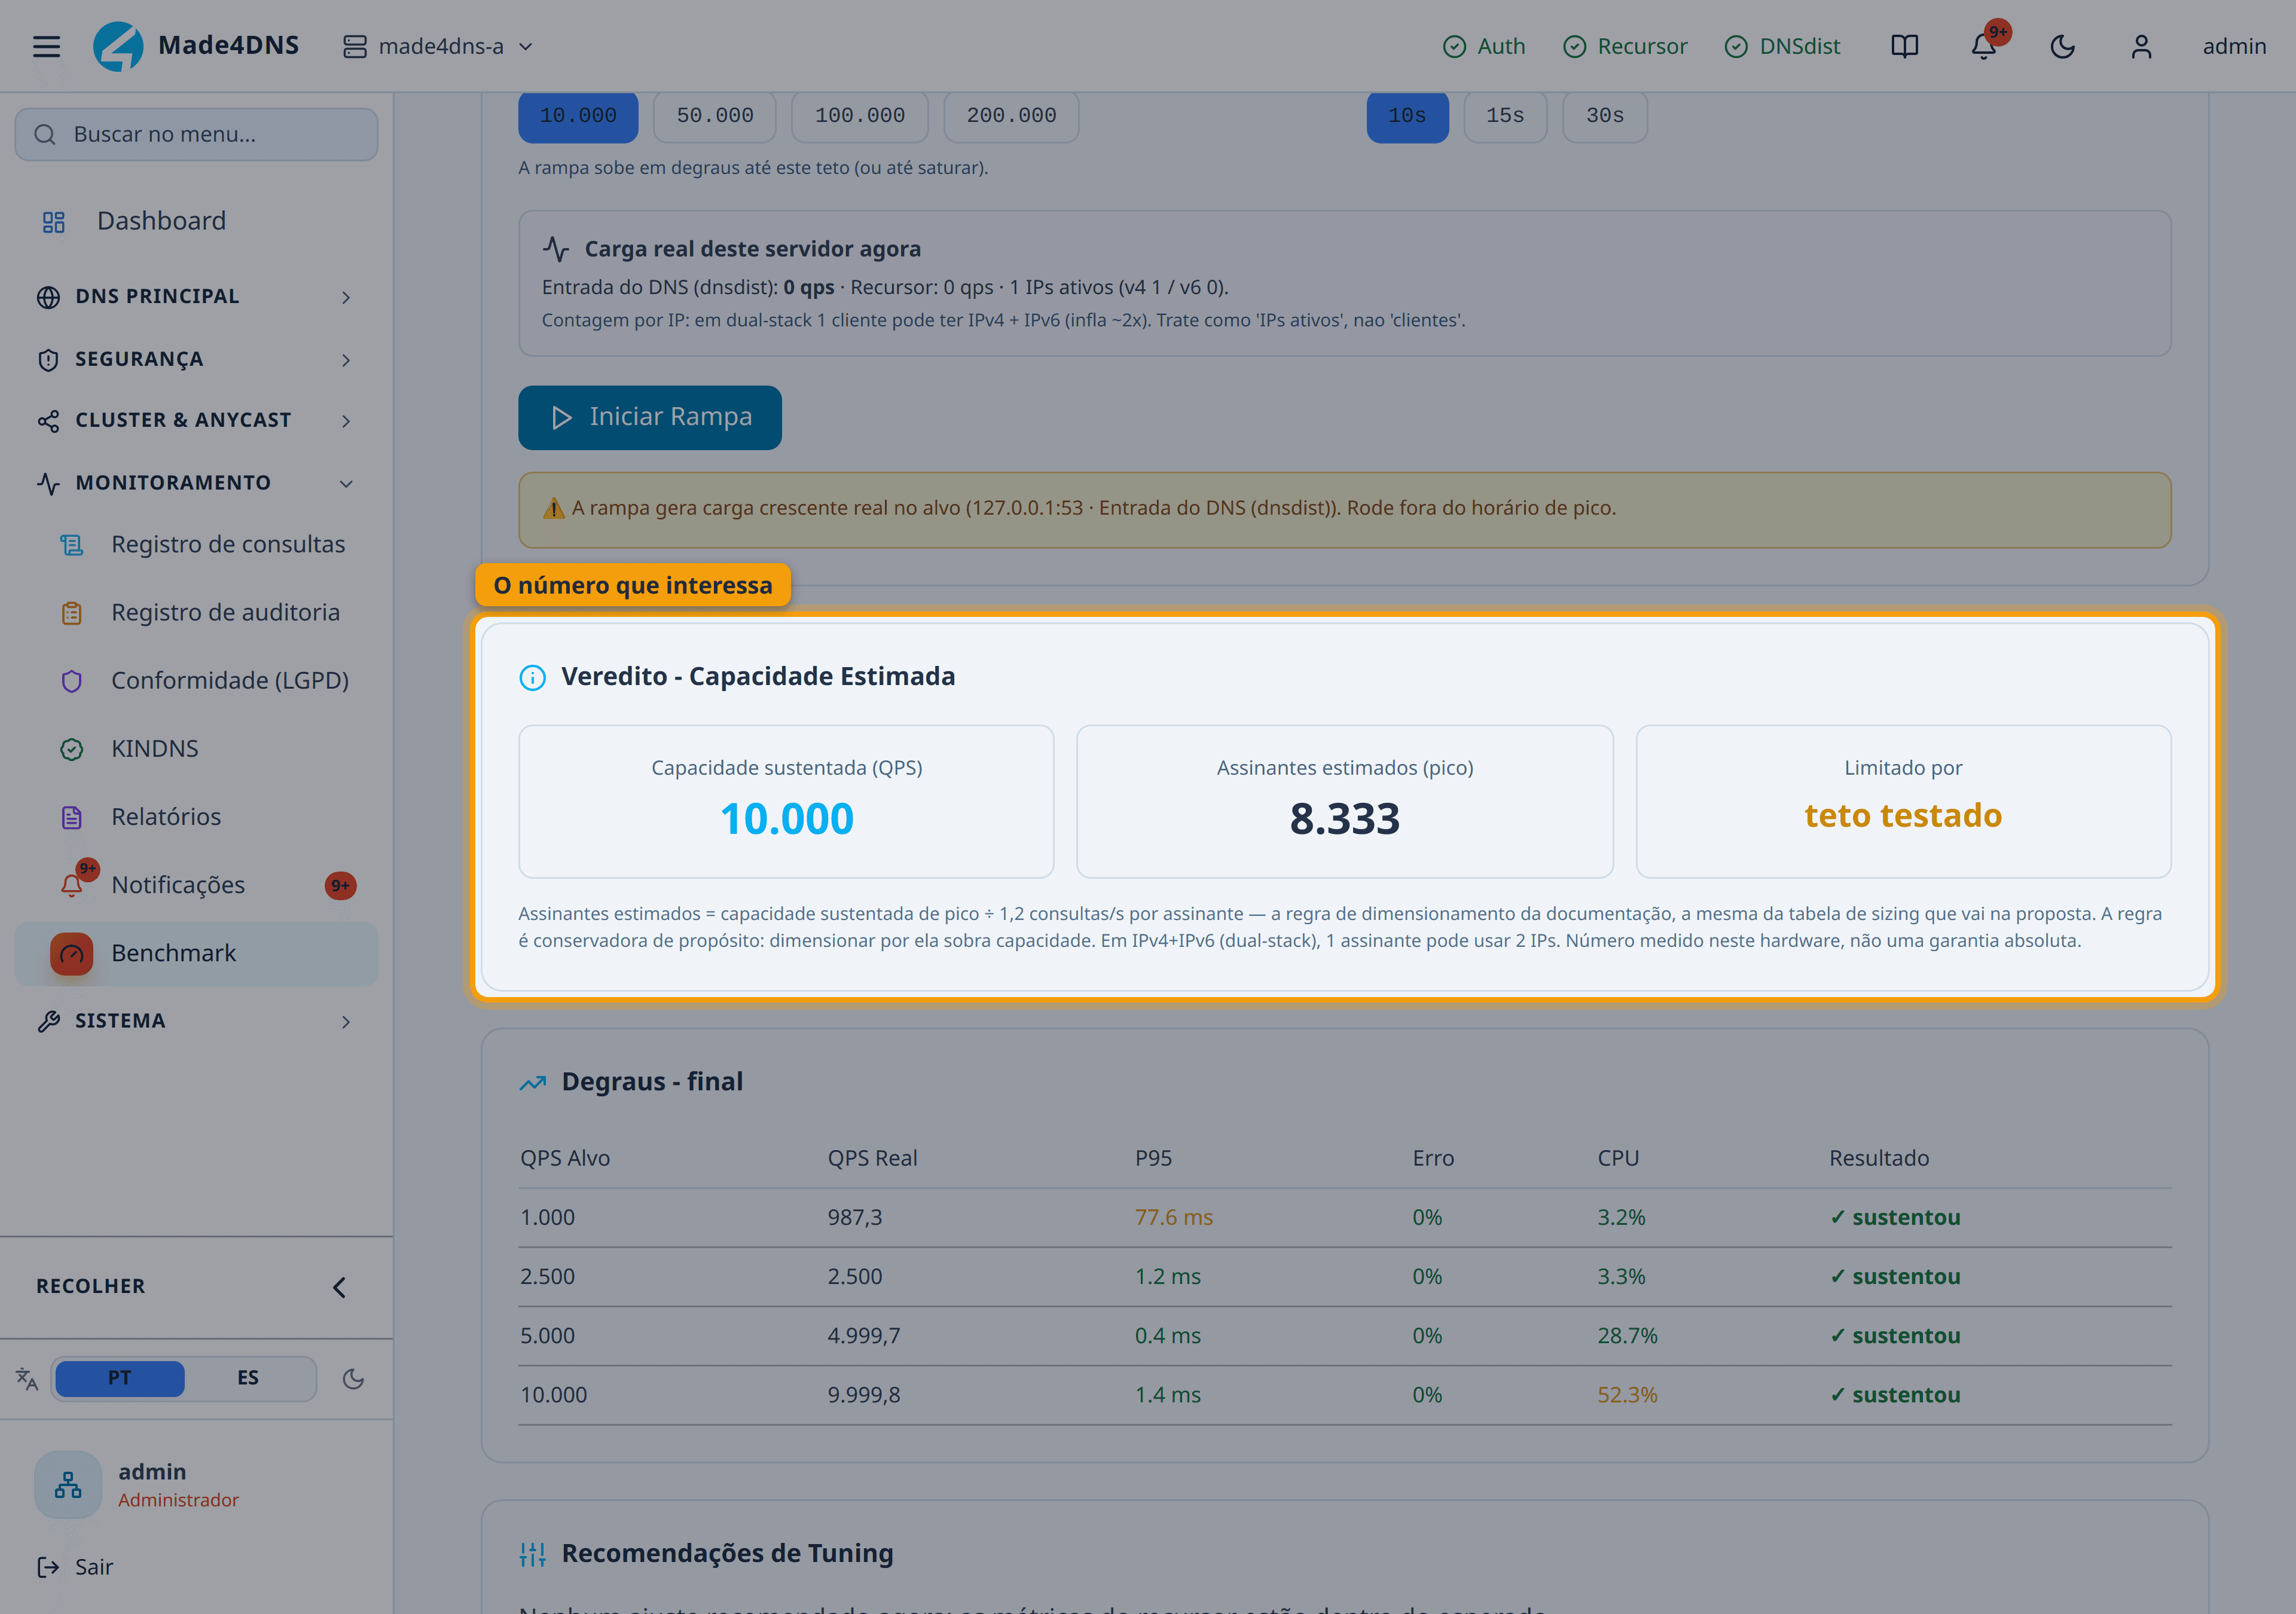
Depois da rampa, o veredito. Capacidade sustentada: 10.000 QPS, e assinantes estimados: 8.333 — a divisão por 1,2 consulta/s por assinante, a mesma regra da tabela de dimensionamento que vai na proposta.
O terceiro quadro é o que muita gente ignora e é o mais importante: Limitado por — teto testado. Quer dizer que a rampa acabou porque o teto configurado chegou ao fim, não porque a máquina saturou. A tabela de degraus confirma: o último degrau sustentou 9.999,8 QPS com 0% de erro e CPU em 52.3%. Ou seja, o número real é maior — o teste é que parou antes.
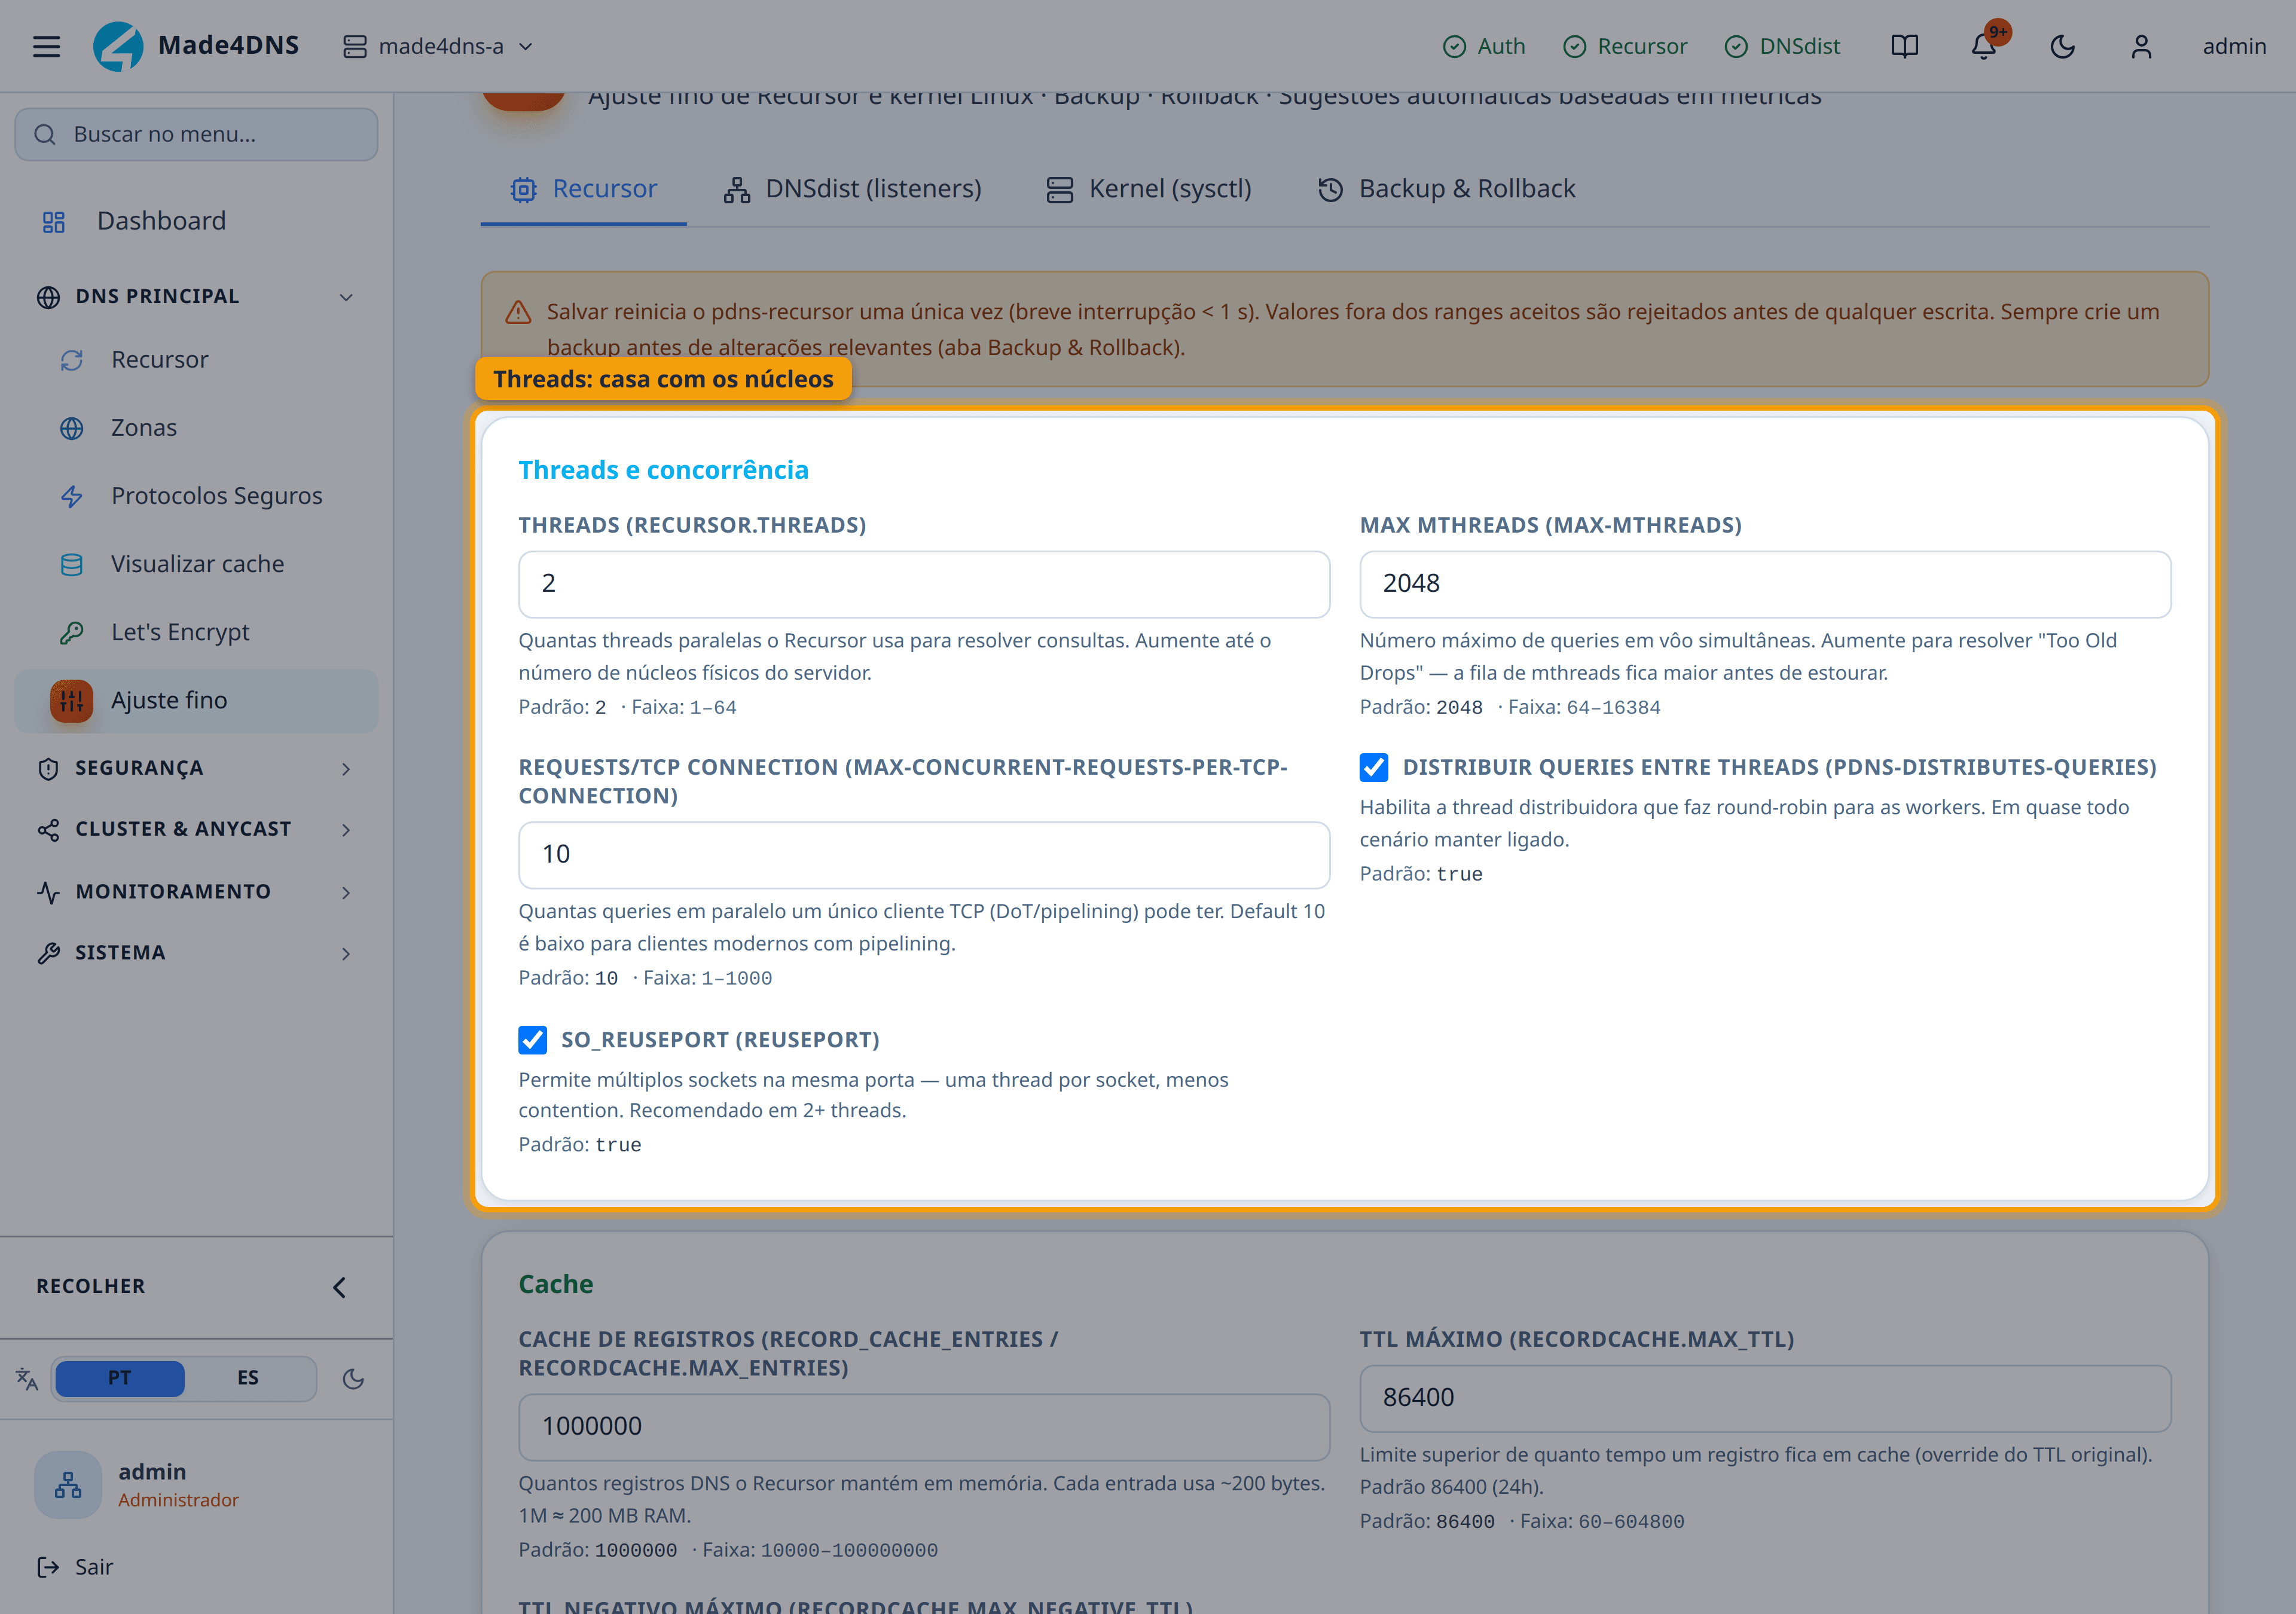
Se o diagnóstico apontou saturação da resolução, é aqui que se mexe. DNS principal → Ajuste fino, aba Recursor.
Threads vale 2 e a própria tela diz até onde subir: até o número de núcleos físicos do servidor. Max mthreads (2048) é a fila de consultas em voo — é o parâmetro que resolve descarte por "Too Old Drops", não o de threads.
Leia o aviso âmbar do topo antes de salvar: salvar reinicia o pdns-recursor uma única vez, com interrupção menor que 1 segundo. Valores fora da faixa são recusados antes de qualquer escrita, e a aba Backup & Rollback existe justamente para o antes de mudanças relevantes.
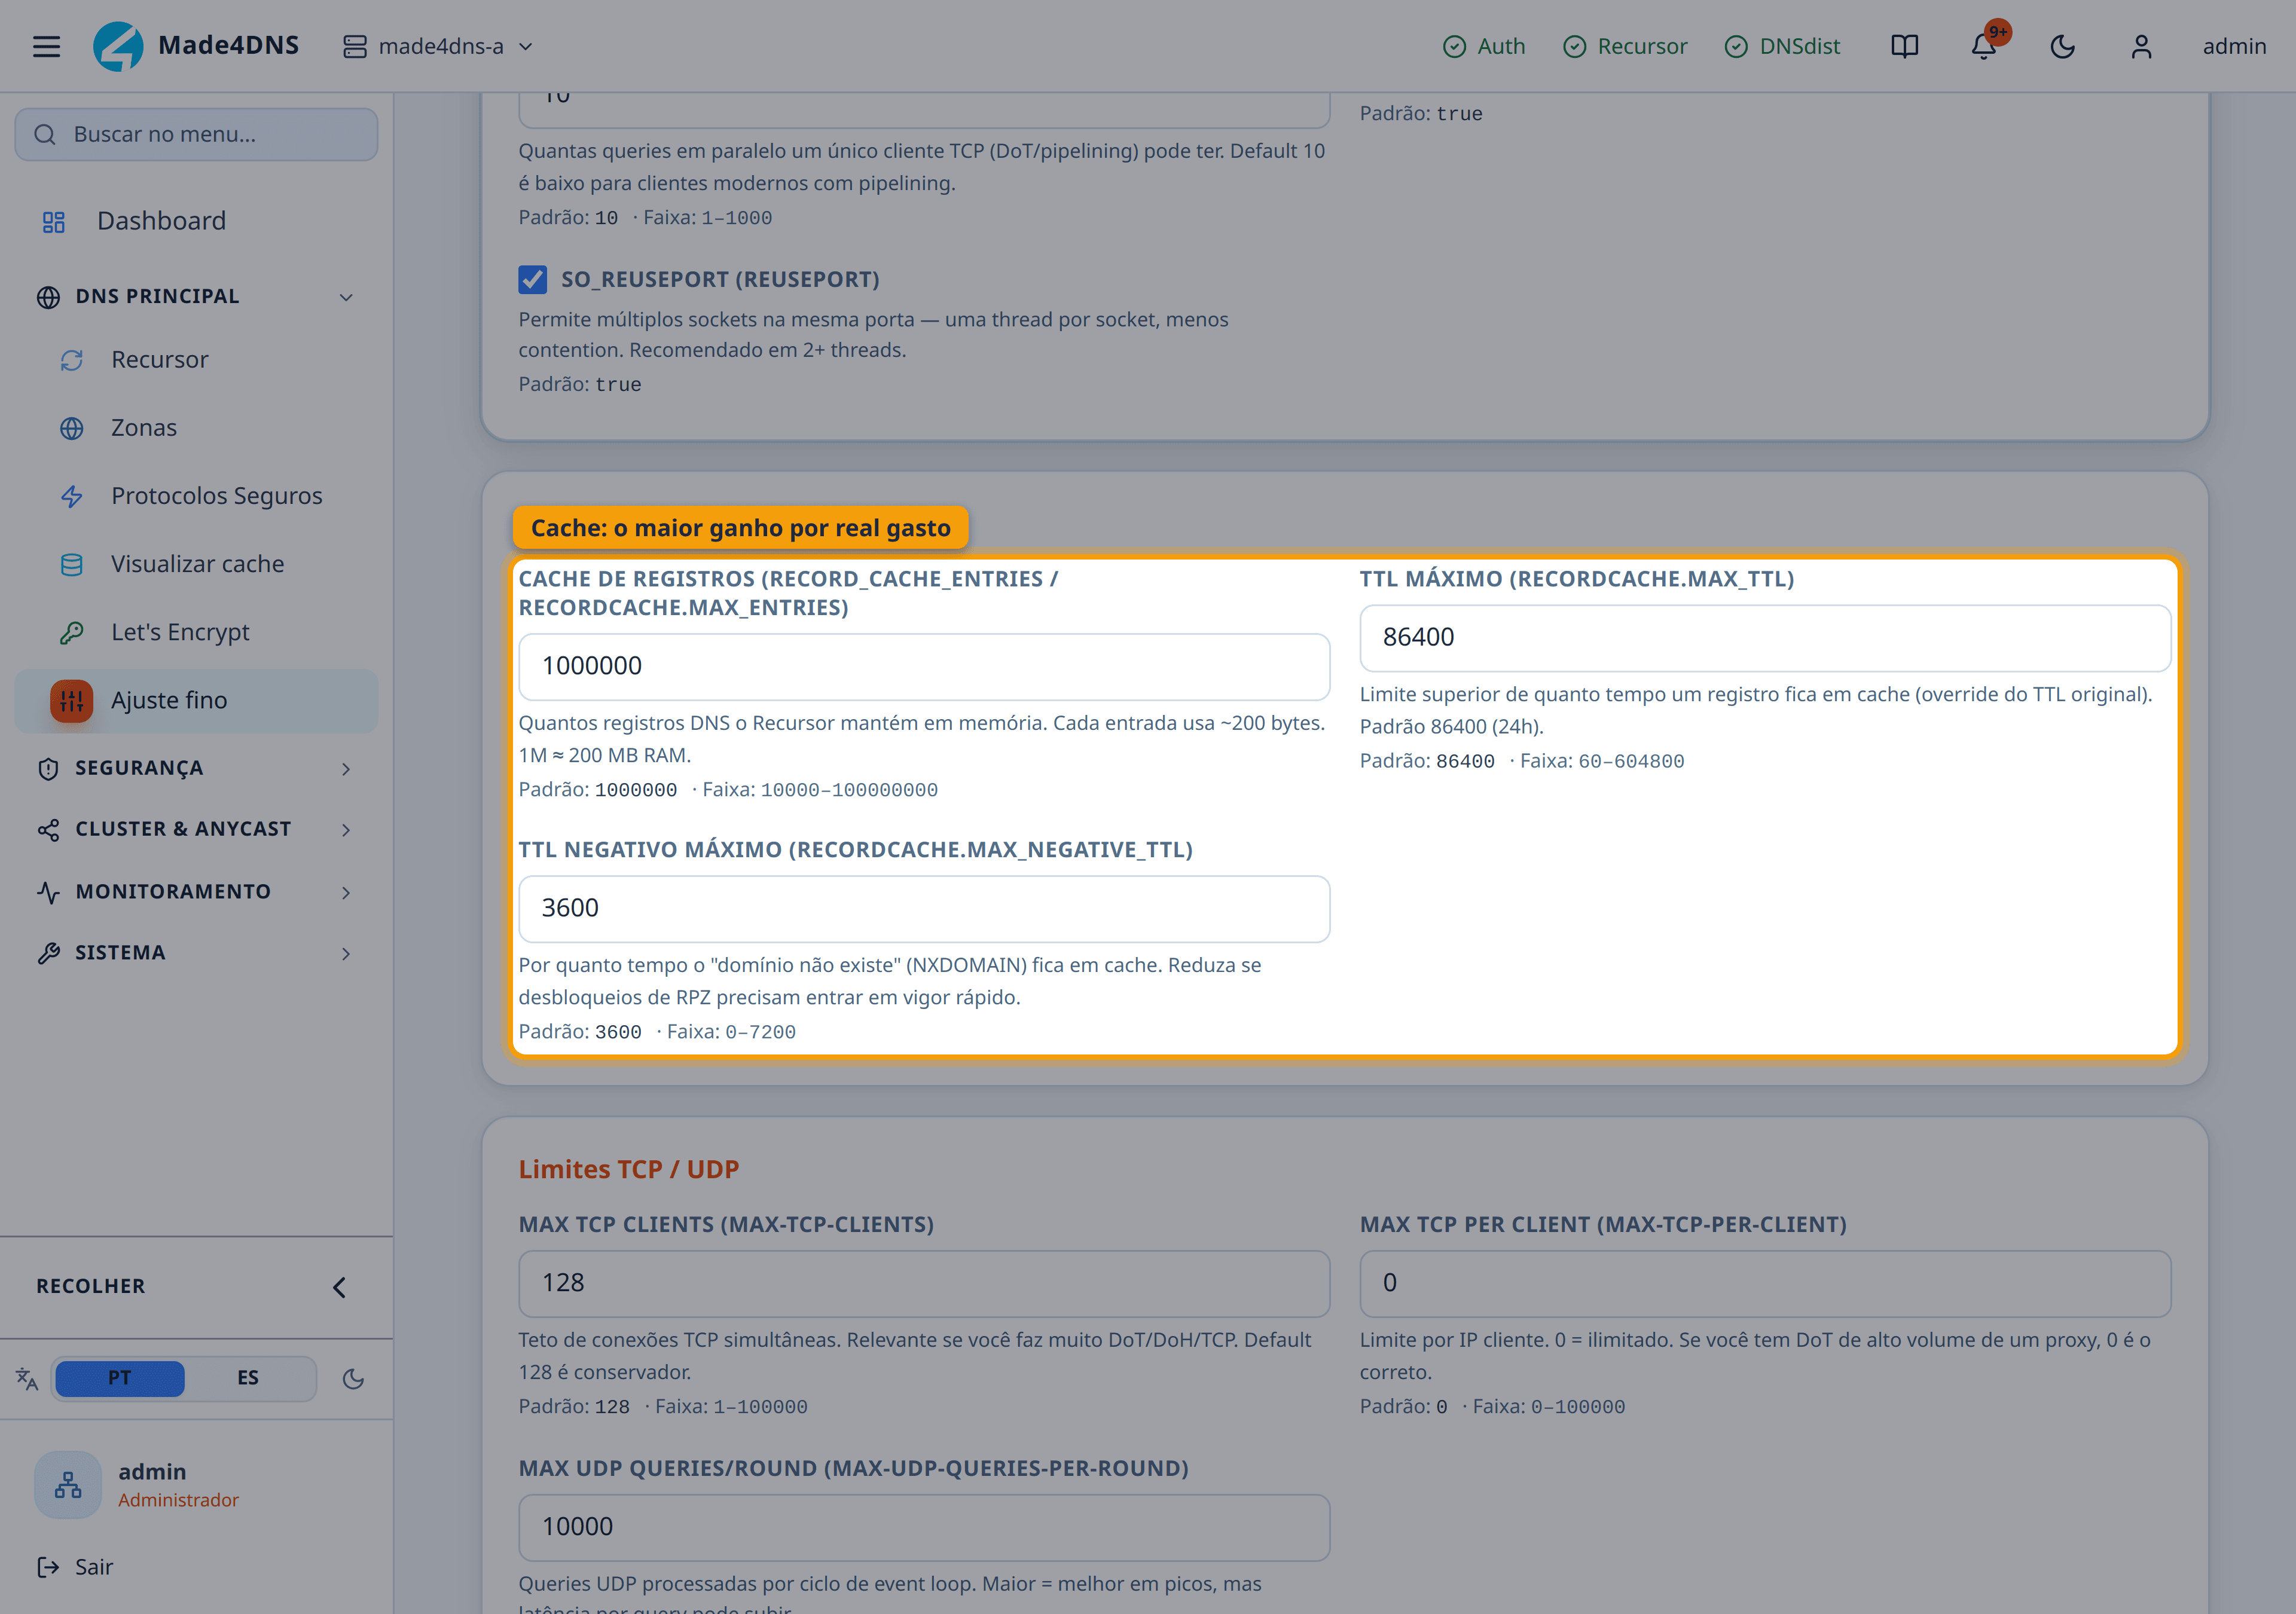
Descendo na mesma aba: o bloco de Cache, que costuma render mais que qualquer ajuste de thread — porque é o acerto de cache que manda na latência média.
Cache de registros vale 1000000, e a tela dá a conta de memória em vez de deixar você adivinhar: cada entrada usa ~200 bytes; 1M ≈ 200 MB de RAM. Aumentar sem essa conta é o caminho mais rápido para a máquina ir para swap — e swap derruba a taxa de acerto em vez de subir.
TTL negativo máximo (3600) é o detalhe que morde no dia a dia: é por quanto tempo um "domínio não existe" fica guardado. Reduza se você precisa que desbloqueios entrem em vigor rápido.
Os dois números, lado a lado
| Latência na entrada | Latência de resolução | |
|---|---|---|
| Mede | O caminho completo, como o cliente vê | Só a falha de cache, que foi resolver pela internet |
| Onde aparece | Número grande do cartão Latência Média | Subtítulo do mesmo cartão |
| Massa saudável | Abaixo de 1 ms, ou entre 1 e 10 ms | 10 a 100 ms é normal |
| Sinal de alerta | Acima de 10 ms: falha de cache ou saturação da entrada | Acima de 1 s: problema nos servidores externos, não no seu |
Os dois histogramas da aba Performance usam as mesmas faixas — abaixo de 1 ms, 1 a 10 ms, 10 a 100 ms, 100 ms a 1 s, acima de 1 s. O que é bom em cada um é diferente, e é essa diferença que separa "o problema é meu" de "o problema é da internet".
O roteiro de cinco minutos
Visão Geral — a foto
Confira a latência média, as consultas por segundo e a taxa de acerto do cache. Compare com o que é normal neste servidor, não com um número absoluto.
Lembre que o seletor de janela — 30m, 1h, 6h, 24h, 7d, 30d, 90d — também manda nos cartões acumulados. Só as consultas por segundo e os clientes "agora" são sempre tempo real.
Performance — qual das duas latências subiu
Olhe o histograma da entrada primeiro.
| Situação | Leitura |
|---|---|
| Entrada com massa acima de 10 ms | O problema é local: falha de cache ou saturação da entrada |
| Entrada boa, resolução acima de 1 s | O problema é externo: os autoritativos da internet estão lentos |
| As duas ruins | Comece pela entrada; ela costuma ser consequência, não causa |
Performance — Em processamento
O contador Em processamento mostra as consultas que o resolvedor está resolvendo agora. Ele não mede volume, mede saturação.
Perto de zero é saudável: o servidor resolve mais rápido do que chega. Centenas ou milhares significam fila — servidores externos lentos, ou o próprio servidor sem capacidade.
Saúde — o servidor está perdendo consulta?
O veredito no topo da aba é calculado sobre a variação recente, não sobre o acumulado desde o boot.
| Veredito | O que significa para a lentidão |
|---|---|
| Sistema Saudável | Nenhum descarte nem tempo esgotado no intervalo recente |
| Atenção Necessária | Apareceram tempos esgotados ou descartes por tempo excedido |
| Problema Crítico | Houve descarte por falta de capacidade — isso é lentidão que vira perda |
Servidor — a máquina aguenta?
Veja a folga de capacidade e, principalmente, o bloco de CPU por thread, que separa recepção de resolução. É esse bloco que diz qual camada é o gargalo.
O acerto de cache é o que mais explica a latência
Uma consulta respondida do cache custa menos de um milissegundo. Uma consulta que precisa ser resolvida pela internet custa dezenas de milissegundos. A latência média do servidor é, na prática, a média ponderada entre essas duas coisas — então a taxa de acerto do cache manda no número final.
| Indicador | Valor saudável | Leitura |
|---|---|---|
| Acerto do cache de pacotes (entrada) | 80% a 95% | É o nível que realmente segura a carga |
| Cache do recursor | Naturalmente baixo | Calculado só sobre o que passou da entrada |
Cache do resolvedor baixo não é defeito
Ver 10% ou 20% no cache do resolvedor com 95% no cache de pacotes é o comportamento correto de uma pilha com camada de entrada na frente: a entrada já absorveu tudo que era repetível, e o que sobra para o resolvedor é nome novo, tempo de vida vencido ou falha.
Ajustar o resolvedor por causa desse número leva a mudanças inúteis.
Quando a latência sobe junto com uma queda do acerto na entrada, procure a causa da queda antes de mexer em qualquer parâmetro:
| Causa da queda de acerto | Como confirmar |
|---|---|
| O servidor reiniciou há pouco e o cache está frio | Tempo ligado na aba Servidor. Sobe sozinho nas primeiras horas |
| As métricas foram zeradas | Registro de auditoria |
| O cache configurado não cabe na memória e a máquina foi para swap | Memória e swap na aba Servidor |
| Mudança recente de tamanho de cache | Ajuste fino e o registro de auditoria |
Lento para resolver, ou lento por saturação?
São as duas famílias de causa, e elas têm assinaturas diferentes. Esta tabela é o coração da página:
| Sinal | Lento para resolver (externo) | Lento por saturação (local) |
|---|---|---|
| Histograma da entrada | Bom | Massa acima de 10 ms |
| Histograma de resolução | Massa acima de 1 s | Pode estar normal |
| Em processamento | Alto — as consultas ficam esperando resposta de fora | Alto |
| Timeouts Externos (aba Saúde) | Crescendo | Estável |
| Descartes por capacidade (aba Saúde) | Zero | Acima de zero |
| CPU por thread | Com folga | Saturada em recepção, resolução, ou nas duas |
| Folga de capacidade | Folga | Atenção ou no teto |
| Afeta quais domínios | Alguns, concentrados | Todos, indiscriminadamente |
A pergunta que resolve o empate
A lentidão afeta todo mundo ou só alguns nomes? Saturação de servidor não escolhe domínio. Lentidão externa é sempre concentrada em alguns destinos — e esses destinos aparecem na Análise de timeouts e falhas, no fim da aba Saúde.
Se for saturação, qual camada
O bloco de CPU por thread da aba Servidor separa as duas camadas, e aumentar a errada não resolve nada:
| Assinatura | Gargalo | Onde ajustar |
|---|---|---|
| Recepção saturada, resolução com folga | Receber os pacotes | Ajuste fino, aba da camada de entrada |
| Resolução saturada, recepção com folga | Resolver | Ajuste fino, aba do resolvedor |
| As duas saturadas | A máquina é pequena para a base | Dimensionamento |
O verde vai até 60% de uso, o âmbar até 85%, e acima disso é vermelho. A folga de capacidade usa a mesma régua: folga abaixo de 60%, atenção entre 60% e 85%, no teto acima.
O teto de capacidade só é uma projeção ao vivo quando há carga real suficiente. Abaixo disso, o número exibido é um valor de referência medido em laboratório — e a tela diz isso. Para o número real do hardware do cliente, o caminho é medir a capacidade.
Lentidão que não é do servidor
Antes de concluir que a máquina está pequena, descarte as causas que produzem o mesmo relato sem nenhuma saturação:
| Causa | Como confirmar | Onde resolver |
|---|---|---|
| Bloqueio com a política descartar em silêncio — o cliente espera até estourar o tempo | Política do domínio na tela de bloqueio | Bloquear domínios: troque para domínio inexistente |
| Encaminhamento de emergência ligado — ele não gera cache | Aba Manutenção do Firewall | Desligue, ou use janelas curtas |
| Cache frio depois de reinício | Tempo ligado na aba Servidor | Nada a fazer: sobe sozinho |
| DoT e DoH custam mais por consulta que UDP | Latência por protocolo, na aba Performance | Esperado; o custo é do TLS |
| A lentidão é da rede do assinante, não do DNS | A latência daqui está normal em todas as faixas | Fora do alcance do DNS |
Na latência por protocolo, um traço significa que não houve tráfego naquele transporte — não que ele esteja com problema. A média é calculada sobre as últimas mil consultas de cada um.
Medir ou ajustar?
Os dois roteiros existem e resolvem problemas diferentes. Escolher errado custa tempo:
| Você quer saber | Caminho |
|---|---|
| Quantas consultas por segundo esta máquina aguenta | Medir a capacidade |
| Se dá para extrair mais da máquina que já existe | Ajustar o desempenho |
| Comparar a latência deste servidor com a de outro resolvedor | Aba de latência do Benchmark |
A ordem correta é medir, ajustar, medir de novo. Sem a medição anterior, não existe "melhorou" — existe só a impressão de que melhorou.
Medir gera carga real
O teste de capacidade faz o servidor trabalhar de verdade. Em produção, isso degrada o serviço enquanto o teste roda. Escolha uma janela de baixo movimento, e depois use Zerar métricas para não contaminar a linha de base com tráfego sintético.
Para uma medição pontual de fora do produto, com acesso ao terminal, o tempo de resposta de uma consulta única:
dig @192.0.2.10 loja.example A +statsArmadilhas
- Olhar só a latência média. Ela mistura acerto de cache com resolução. Os histogramas contam a história; a média esconde.
- Tratar o cache do resolvedor como se fosse o cache principal. Ele é naturalmente baixo.
- Ler "Em processamento" como volume. É saturação, não vazão.
- Comparar com o servidor de outra pessoa. A referência útil é o próprio servidor na semana passada.
- Ajustar sem medir antes. Sem linha de base, o ajuste é palpite com risco.
- Achar que os números travaram. A atualização automática pausa quando a aba do navegador vai para segundo plano.
- Confundir lentidão com falha. Se o sintoma é "não abre" e não "demora", o roteiro é diagnosticar um domínio que não resolve.
Onde continuar
| Se o diagnóstico foi | Vá para |
|---|---|
| A máquina está no teto | Medir a capacidade |
| Há folga e os parâmetros estão conservadores | Ajustar o desempenho |
| A resolução está degradada por causa da rede | O servidor está saudável? |
| Outro sintoma | Índice de sintomas |